
BLOG SEOXAN
Mantente al dia sobre las últimas tendencias en marketing digital y seguridad informática
Categorias
Últimas entradas en el blog
Vulnerabilidades críticas en nginx y Java: qué se sabe y cómo actuar
Fecha: 2026-11-18 23:02:55Autor: Alex Rubio
Dos vulnerabilidades críticas en nginx y Java, publicadas en la segunda quincena de noviembre de 2026, obligan a revisar servidores web y aplicaciones empresariales. Según los análisis de Rapid7, Xint y otros investigadores, F5, la empresa responsable de nginx, publicó el 18 de noviembre actualizaciones para dos fallos en su soporte de HTTP/2 que, en determinadas condiciones, permiten ejecutar código sin necesidad de contraseña. Un día antes, Oracle había publicado parches para Java4Shell, un fallo en el decodificador Base64 de Java que, según la firma que lo descubrió, permite tomar el control de herramientas como Jenkins, Jira o Confluence.
Ambos casos comparten un rasgo importante: no afectan a todos los servidores por igual, sino a los que cumplen ciertas condiciones de versión, configuración o hardware. Por eso conviene entender bien qué se ha descubierto antes de reaccionar. Los datos de este artículo proceden de los análisis de las firmas investigadoras y de medios especializados; para cerrar cualquier duda, la referencia final son los avisos oficiales de F5 y de Oracle.
Qué falla en nginx y a quién afecta
nginx es un servidor web, el programa que responde a las peticiones de los navegadores. Funciona como la recepción de un edificio: atiende a todo el que llama y lo dirige a donde corresponde. Los fallos descubiertos están en su soporte de HTTP/2, la versión del protocolo web que permite enviar varias peticiones a la vez por una misma conexión.
Las vulnerabilidades tienen los identificadores CVE-2026-123633 y CVE-2026-123007. Un CVE es el código público con el que se registra cada fallo de seguridad, y el CVSS es una escala de gravedad de 0 a 10. Según los análisis publicados, ambos fallos reciben un 9,2 en la versión 4.0 de esa escala. Red Hat, por su parte, clasifica CVE-2026-123007 como crítico con un 8,1, y Ubuntu le asigna prioridad alta.
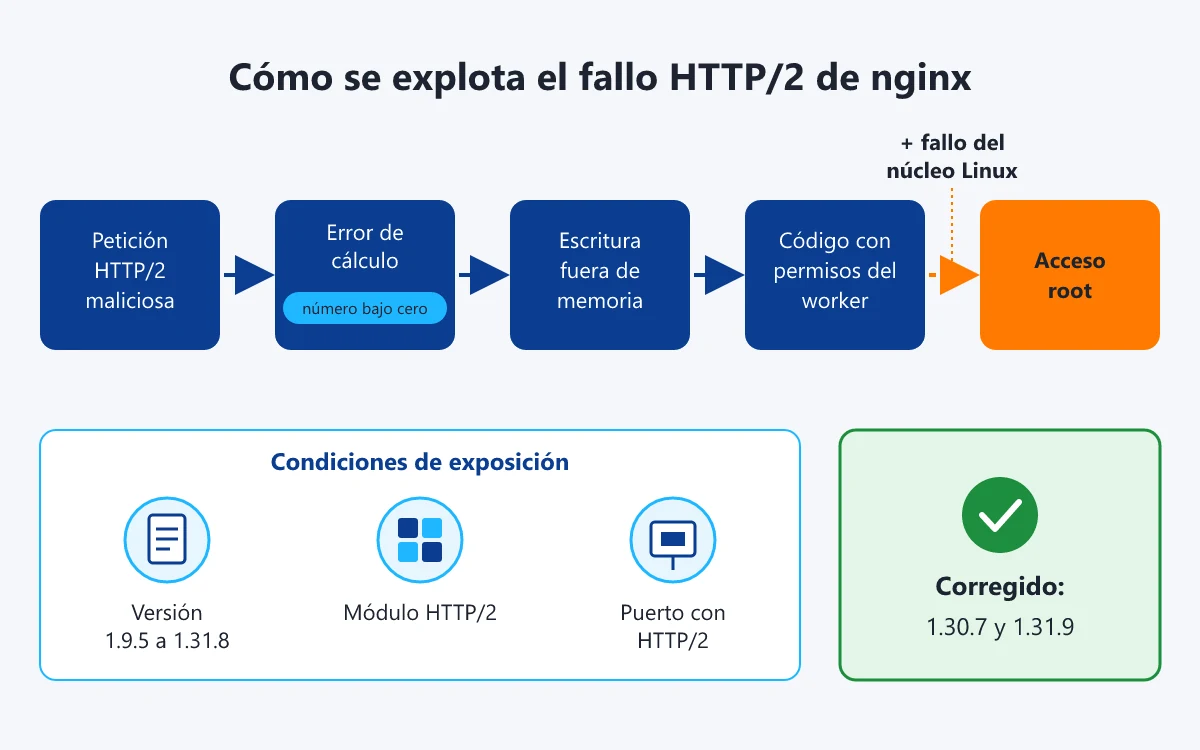
El origen técnico es un desbordamiento por defecto de enteros: un número que baja de cero y da la vuelta hasta convertirse en un valor enorme, como un cuentakilómetros que al retroceder desde cero mostrara una cifra absurda. Ese cálculo erróneo hace que nginx escriba fuera de la zona de memoria que tenía reservada, algo parecido a llenar una hoja y seguir escribiendo en la siguiente, que pertenece a otra persona. Según Rapid7, el resultado puede ser la ejecución remota de código, es decir, que un atacante haga ejecutar órdenes al servidor desde fuera. Ese código se ejecuta con los permisos del proceso worker, cada uno de los procesos que nginx usa para atender peticiones.
Las condiciones para estar expuesto están bien definidas. Según los investigadores, el servidor debe usar una versión entre la 1.9.5 y la 1.31.8 sin parchear, incluir el módulo HTTP/2 y tener al menos un puerto que ofrezca HTTP/2. De acuerdo con la información atribuida a F5, el servidor debe estar además con pocas conexiones disponibles, y en muchos casos el fallo solo tumba el proceso, mientras que la ejecución de código requiere condiciones adicionales. Entre los descubridores figuran Wiz, Rapid7 y Xint.
Java4Shell: un fallo en el decodificador Base64 de Java
El segundo caso, bautizado como Java4Shell y registrado como CVE-2026-114938, afecta al entorno de ejecución de Java, el componente que hace funcionar los programas escritos en ese lenguaje. El fallo está en la función que decodifica Base64, un sistema que convierte datos binarios en texto y que se usa mucho en inicios de sesión y subidas de archivos. Según el análisis del centro luxemburgués CIRCL, un relleno mal formado al final del texto provoca un cálculo de longitud negativo, y eso lleva a Java a escribir fuera de la zona de memoria que le corresponde.
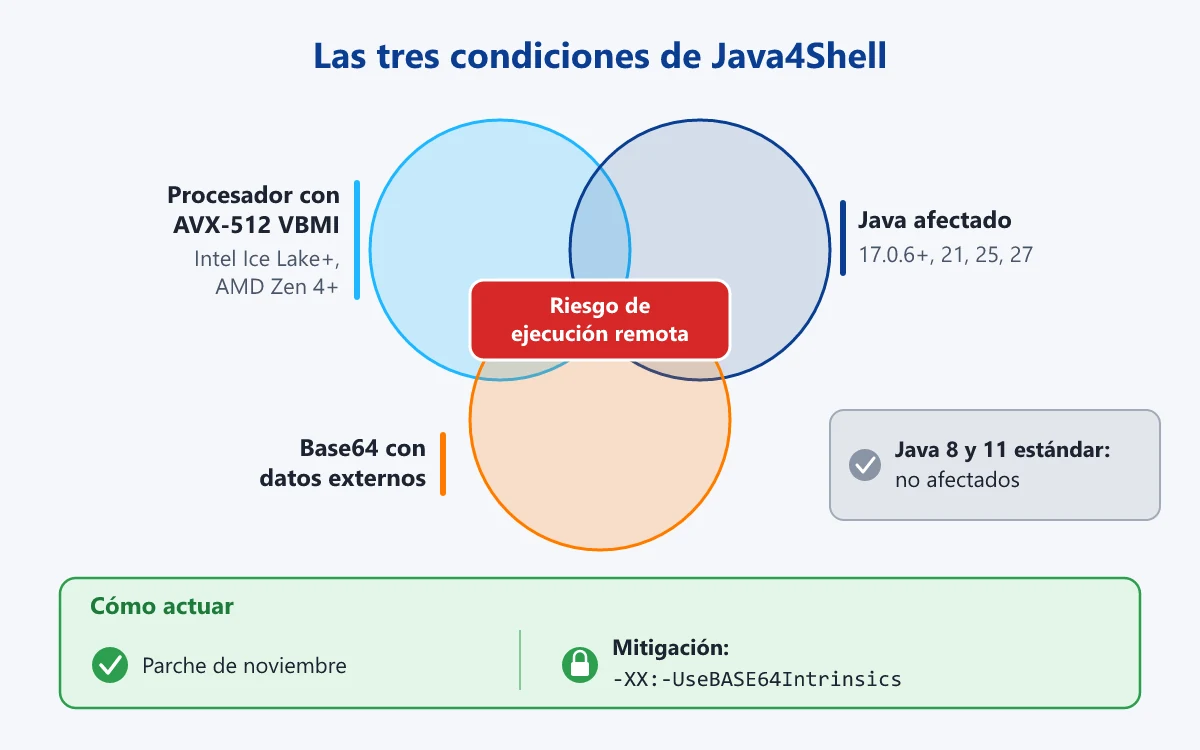
El código vulnerable solo se activa en procesadores x86-64 con AVX-512 VBMI, un conjunto de instrucciones que acelera ciertas operaciones. Según Red Hat, están afectados los Intel Ice Lake y posteriores y los AMD Zen 4 y posteriores. Algún análisis amplía la lista a chips Intel de equipos de cliente de 2019 a 2021, como Tiger Lake o Rocket Lake, una discrepancia que conviene resolver con el aviso de Oracle.
En cuanto a versiones, los análisis señalan Java 17.0.6 y posteriores, además de Java 21, 25 y 27. Java 8 y Java 11 estándar no incluyen el código vulnerable, con una excepción: el Java SE 8 Performance Pack 8u511b33-perf. OpenJDK y cve.org asignan al fallo un 8,1 de gravedad, con una complejidad de ataque alta. Oracle acredita el hallazgo a Quang Luong, de la firma Calif.
Calif afirma haber convertido el fallo en ejecución remota de código sin autenticación en aplicaciones populares con su configuración por defecto, entre ellas Jenkins, Jira, Confluence, Keycloak, JFrog Artifactory y PingFederate. Sin embargo, en el momento de los primeros análisis, Atlassian, Jenkins y Ping no habían publicado avisos propios, por lo que esta parte debe leerse como una afirmación de los investigadores aún sin verificación independiente.
Del laboratorio a los servidores reales
Una prueba de concepto es un programa que demuestra que un fallo se puede aprovechar. En el caso de nginx, Rapid7 desarrolló una que logra ejecución remota en una imagen Docker de nginx 1.31.8, y según los análisis publicados apareció en GitHub un exploit funcional el mismo día de la divulgación. Xint, por su parte, describe una cadena que combina fallos de nginx con un fallo del núcleo de Linux para obtener acceso root, es decir, control total del equipo.
A esto se suma un detalle relevante para quien confía en los contenedores. Un contenedor aísla una aplicación con sus dependencias, pero comparte el núcleo del sistema con el equipo anfitrión, de modo que no protege por sí solo frente a estos fallos. Aun así, según Qualys, a 17 de noviembre de 2026 no había confirmación pública de ataques reales, y las demostraciones conocidas son de laboratorio.
Lo que se dice de las vulnerabilidades de nginx y Java y lo que dicen los datos
| Afirmación que circula | Veredicto | Explicación |
|---|---|---|
| Si tu web usa nginx o Java, pueden entrar sin contraseña | Incompleto | Solo están expuestos los servidores que cumplen condiciones concretas de versión, configuración de HTTP/2 o procesador y uso de Base64 con datos externos. |
| nginx está detrás de tres de cada diez webs del mundo | Sin confirmar | No hemos encontrado una fuente que lo acredite. Según Precursor Security, el buscador Censys contabiliza unos 9,5 millones de servicios nginx con versión afectada y HTTP/2 activo, una cifra de exposición, no de cuota de mercado. |
| De cada cien servidores que muestran su versión, 99 están afectados | Incompleto | Un escaneo de Xint halló que el 98,9 % de 11,94 millones de servidores estaba en el rango afectado, pero muchas distribuciones Linux aplican parches sin cambiar el número de versión. |
| Casi la mitad de las empresas usa versiones de Java afectadas, según una encuesta de Azul | Sin confirmar | No hemos localizado esa encuesta ni sus cifras. |
| El fallo de nginx llevaba once años escondido | Cierto, con matiz | El error procede de la versión 1.9.5, de septiembre de 2015. Otro fallo de nginx, de tipo use-after-free (usar memoria ya liberada), existe desde la 1.19.7, de febrero de 2021. |
| Ya hay una prueba de concepto pública | Cierto | Rapid7 publicó una demostración y un exploit funcional apareció en GitHub el día de la divulgación. |
| Los investigadores han llegado a root | Incompleto | Según Xint, hace falta encadenar un fallo adicional del núcleo de Linux. Rapid7 indica que la ejecución como proceso maestro o root no se ha demostrado con nginx solo. |
| Se han ejecutado comandos en Jira, Confluence o Jenkins | Sin confirmar de forma independiente | Es una afirmación de Calif; los fabricantes no habían publicado avisos propios en los primeros análisis. |
| Java solo es vulnerable en algunos procesadores Intel y AMD modernos | Cierto | Requiere procesadores x86-64 con AVX-512 VBMI. |
| Desactivar HTTP/2 basta mientras se actualiza | Incompleto | Bloquea CVE-2026-123007 y CVE-2026-123633, pero no otro de los fallos de nginx recopilados por Xint. |
| No hay ataques confirmados | Cierto a 17 de noviembre | Qualys no tenía constancia pública de explotación real en esa fecha. |
Qué significa para ti
Si gestionas una web o una intranet, o encargas su mantenimiento, lo prudente es revisar ambos frentes cuanto antes, aunque no haya ataques confirmados. Estas son las medidas que recogen los análisis consultados:
- Actualiza nginx a la versión 1.30.7 (estable) o 1.31.9 (mainline), que corrigen los dos fallos de HTTP/2, y reinicia el servicio para que se aplique.
- Si usas nginx de tu distribución Linux, consulta su aviso de seguridad: el número de versión puede no reflejar que ya está parcheado.
- Si no puedes actualizar de inmediato, desactiva HTTP/2 de forma temporal, sabiendo que no cubre todos los fallos.
- Actualiza Java con los parches de noviembre, también en los entornos que vienen dentro de productos de terceros y en las imágenes de contenedores.
- Como medida provisional en OpenJDK, arranca la aplicación con la opción -XX:-UseBASE64Intrinsics, que desactiva la aceleración vulnerable.
- Sigue los avisos de los fabricantes de herramientas como Jira, Confluence, Jenkins o Keycloak.
En resumen
Las vulnerabilidades críticas en nginx y Java publicadas en noviembre de 2026 son reales y graves, con pruebas de concepto disponibles, pero solo afectan a servidores que cumplen condiciones concretas. En nginx, la exposición depende de la versión y de tener HTTP/2 activo; en Java, de la versión, del procesador y de cómo usa la aplicación el decodificador Base64. Algunas cifras que circulan están sin confirmar o necesitan matices, y a 17 de noviembre no constaban ataques reales. La respuesta recomendada es actualizar nginx y Java, incluidos los entornos dentro de contenedores y productos de terceros, y aplicar las mitigaciones temporales mientras tanto.
Fuentes
- Rapid7: CVE-2026-123007, Critical NGINX HTTP/2 Integer Underflow Leads to RCE
- Xint: NGINX2Root, New Remote Code Execution Vulnerabilities in nginx
- Cybersecuritynews: NGINX HTTP/2 Flaws Could Allow Memory Corruption and RCE
- Precursor Security: NGINX2Root (CVE-2026-123007), Live nginx RCE Updates
- Aikido: nginx2root, critical nginx RCE vulnerabilities and how to fix them
- MLQ.ai: Nginx patches a decade-old HTTP/2 flaw
- Pasquale Pillitteri: Two NGINX HTTP/2 flaws let attackers run code without a login
- The CyberSec Guru: Nginx HTTP/2 Vulnerability CVE-2026-123633, CVE-2026-123007
- Calif: Java4Shell, Write once, RCE everywhere
- CIRCL: TR-104, Critical Memory Corruption in OpenJDK Base64 Decoder
- CCB (Bélgica): aviso sobre Java4Shell
- Qualys: How to Find, Mitigate, and Patch the Critical Java4Shell Flaw
- Bastionzero: Java4Shell OpenJDK flaw enables RCE in Jenkins, Jira
- Salesforce: Java4Shell, Critical OpenJDK Vulnerability
- Pentestit: Java4Shell, Exposure, Fixes and Detection
- Hackplayers: Java4Shell (CVE-2026-114938)
Escape de contenedores Docker: cómo ocurre y cómo evitarlo
Fecha: 2026-11-16 16:02:00Autor: Alex Rubio
Muchas webs, tiendas online y aplicaciones de empresa funcionan hoy dentro de contenedores, y la herramienta más conocida para crearlos es Docker. Su gran promesa es el aislamiento: cada aplicación vive en su propio espacio, separada del resto del servidor. Por eso preocupa tanto el escape de contenedores Docker, conocido en inglés como «Docker breakout»: que alguien que ha entrado en uno de esos espacios consiga saltar al sistema que lo ejecuta y tomar el control de la máquina entera.
¿Es tan sencillo como a veces se cuenta? La respuesta corta es que depende mucho de cómo esté configurado el servidor. En este artículo explicamos qué es un contenedor, qué significa escapar de él, qué partes de las historias que circulan son ciertas y cuáles están simplificadas, y qué puede hacer cualquier empresa para no ponérselo fácil a un atacante.
Qué es un contenedor y qué significa escapar de él
Un contenedor es una especie de caja aislada en la que se ejecuta una aplicación con sus propios archivos y sus propios procesos, que son los programas en marcha. La diferencia con una máquina virtual es que todos los contenedores de un servidor comparten el núcleo del sistema operativo anfitrión, es decir, la pieza central de Linux que gestiona la memoria, los discos y los permisos.
Una buena comparación es un hotel. Cada habitación tiene su puerta y su llave, y el huésped no ve lo que ocurre en las demás. Pero todas comparten la estructura del edificio, las tuberías y la instalación eléctrica. Escapar del contenedor sería algo parecido a que un huésped encontrara la forma de salir de su habitación y llegar al cuarto de máquinas, desde donde se controla todo el edificio.
El término «Docker breakout» tiene recorrido en el mundo de la seguridad: aparece en HackTricks, una guía muy utilizada por profesionales de las pruebas de intrusión, en una sección dedicada a estas técnicas, donde también se usa «container escape» como concepto equivalente. Para entender cómo funciona hace falta conocer antes a un personaje clave de Linux: el usuario root.
Root dentro del contenedor, ¿root también fuera?
En Linux, root es el usuario con control total del sistema. El sistema no lo reconoce por su nombre, sino por un número, el identificador de usuario o UID, que en su caso es el 0. Cada vez que alguien intenta leer un archivo o cambiar una configuración, Linux consulta ese número para decidir si lo permite. Pasar de un usuario con pocos permisos a uno con más se llama escalada de privilegios, y es justo lo que busca un atacante.
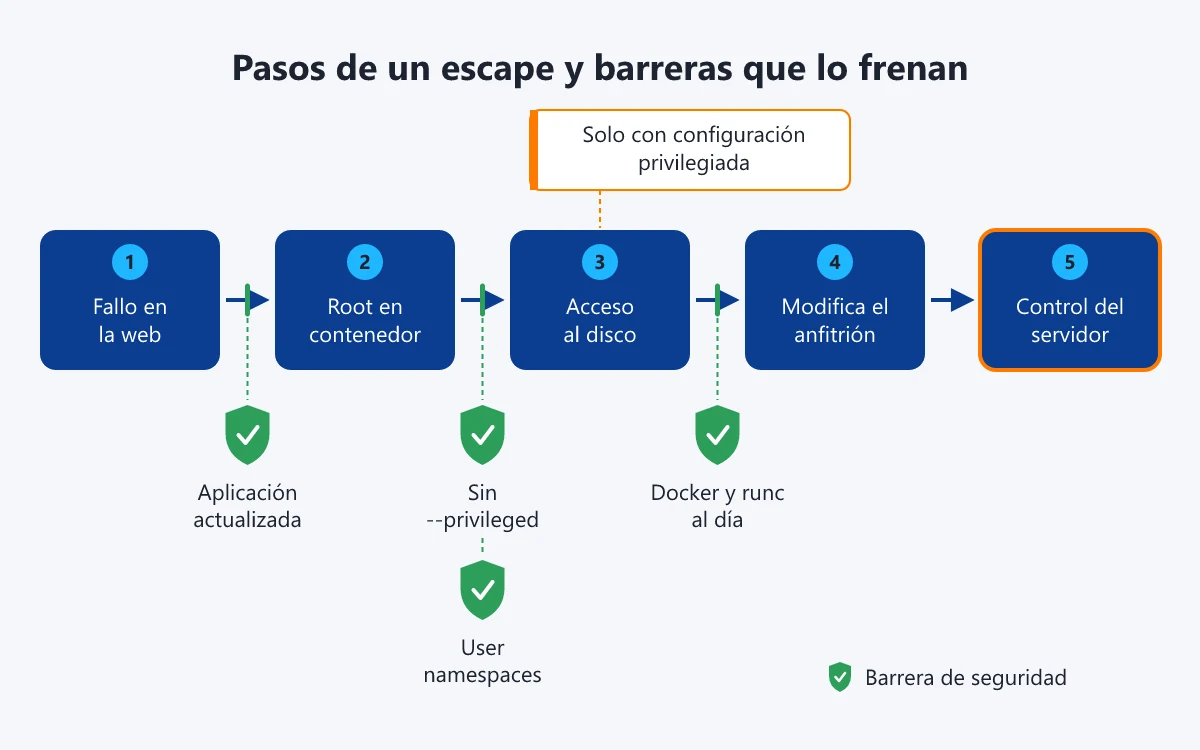
Una idea muy extendida es que, si alguien consigue ser root dentro de un contenedor, ya tiene medio camino hecho para ser root en todo el servidor. Hay parte de verdad: según KodeKloud y StackHarbor, en una instalación de Docker con la configuración por defecto, el root del contenedor es el mismo usuario con UID 0 que el root del anfitrión. Lo que lo mantiene encerrado son otras barreras del sistema, no el hecho de ser un usuario distinto.
Sin embargo, la afirmación está incompleta, porque existe una función llamada espacios de nombres de usuario (user namespaces). Con ella activada, el «root» del contenedor se convierte, de cara al exterior, en un usuario sin poder real. Es como un conserje que tiene las llaves de todas las puertas de su planta, pero ninguna del resto del edificio. Según esas mismas fuentes, en ese caso el root del contenedor no puede actuar como root del anfitrión, salvo que encuentre además otra vía de escalada.
El matiz importante es que esta protección no viene puesta de serie. De acuerdo con InfoSec Institute, los espacios de nombres de usuario están disponibles en Docker desde la versión 1.10, pero Docker no los utiliza por defecto: hay que activarlos expresamente.
Cómo se produce un escape de contenedores Docker
La vía de escape más documentada no se basa en un fallo de Docker, sino en una configuración demasiado generosa. Docker permite arrancar un contenedor con la opción --privileged, que, según SecureLayer7, le concede casi todas las capacidades especiales de Linux y acceso a los dispositivos del anfitrión, incluidos sus discos. Esa misma fuente la considera el error de configuración de mayor impacto.
Con esa puerta abierta, el escape suele ser bastante directo. Desde dentro del contenedor se puede montar la partición principal del servidor, es decir, conectarla para leer y escribir en ella como si fuera una carpeta más. A partir de ahí, según recoge un repaso de técnicas de escape publicado en DEV Community, el atacante puede programar una tarea automática que el servidor ejecutará como root o modificar el archivo de cuentas de usuario (/etc/passwd) para crear una cuenta con todos los permisos. Otro paso que se menciona a menudo, añadir una clave SSH a la cuenta de root, persigue lo mismo: SSH es el sistema de acceso remoto cifrado a servidores, y una clave autorizada permite entrar sin contraseña.
Una variante que circula: el «puente» del mismo usuario
También circula una versión más elaborada de la historia. En ella, el atacante tiene dos accesos a la vez: es root dentro de un contenedor y, gracias a unas credenciales que encuentra en un archivo, tiene además una cuenta modesta en el servidor anfitrión. Dentro del contenedor crea un acceso directo al disco y un usuario con el mismo número identificador que su cuenta de fuera, lanza un programa con ese usuario y, desde el anfitrión, entra en los archivos de ese programa para usar el acceso al disco como puente.
La explicación que suele acompañarla es que en Linux todo lo que ve un proceso es accesible desde fuera si corre con el mismo identificador de usuario. Esto solo es cierto a medias. Según el manual de Linux sobre /proc, el directorio especial donde el sistema muestra los procesos en marcha, el acceso a la vista de archivos de otro proceso está sujeto a la misma comprobación que ptrace, la función que permite inspeccionar otro programa. Y esa comprobación exige algo más que compartir número: el proceso debe poder inspeccionarse, cosa que no ocurre si ha cambiado de usuario o ha arrancado con privilegios especiales. Además, según la documentación del núcleo de Linux, el módulo de seguridad Yama puede limitar esa inspección a la relación entre un programa y los que él mismo ha lanzado. Es como mirar por la ventana de la casa de al lado: solo es posible si se cumplen ciertas condiciones, y muchas casas tienen cortinas.
Las fuentes consultadas sí documentan estas piezas por separado, pero no hemos encontrado ninguna que describa esta cadena exacta ni un caso real en el que se haya empleado. Tampoco se suele indicar con qué versión de Docker ni con qué configuración funcionaría, así que conviene tomarla como un escenario de laboratorio posible, no como algo demostrado que funcione en cualquier servidor.
Cuando el fallo está en el propio software
Aunque la mayoría de escapes se apoyan en malas configuraciones, también ha habido fallos en el software. El caso más conocido es CVE-2019-5736 (un CVE es el código público con el que se identifica una vulnerabilidad conocida). Afectaba a runc, el programa de bajo nivel que se encarga de arrancar los contenedores, y lo divulgaron el 11 de febrero de 2019 los investigadores Adam Iwaniuk y Borys Popławski.
Según Red Hat, el fallo permitía que un contenedor malicioso obtuviera acceso root en la máquina anfitriona. Afectaba a runc hasta la versión 1.0-rc6 y a Docker en versiones anteriores a la 18.09.2. Las fuentes no coinciden del todo sobre las condiciones necesarias para aprovecharlo: Qualys habla de contenedores privilegiados, mientras que una prueba de concepto publicada en GitHub exige ser root dentro del contenedor. En cualquier caso, el episodio muestra que mantener el software actualizado es tan importante como configurarlo bien.
¿Y a mí en qué me afecta?
Si tienes una web o una aplicación alojada en contenedores, aunque no los gestiones tú, conviene saber que un escape casi siempre es el segundo paso de un ataque. Primero alguien tiene que lograr ejecutar órdenes en tu aplicación, por ejemplo aprovechando un fallo en la web. Estas son las medidas que merece la pena comentar con quien administre tu servidor:
- Evitar los contenedores privilegiados: la opción --privileged solo debería usarse cuando sea imprescindible, porque abre el acceso a los discos del anfitrión.
- Activar los espacios de nombres de usuario, para que el root del contenedor no equivalga al root del servidor.
- Valorar el modo sin root (rootless): según DevOpsBeast, en este modo el propio motor de contenedores funciona como un usuario normal.
- Mantener Docker y runc actualizados, como demuestra el caso de 2019.
- No dejar contraseñas ni credenciales en archivos dentro de los contenedores ni reutilizarlas en otras cuentas: en muchos ataques son el puente entre un acceso y el siguiente.
- Tener al día la propia aplicación y sus complementos, para cerrar la primera puerta.
Nada de esto significa que los contenedores sean inseguros. Bien configurados, añaden una capa de separación valiosa. El riesgo aparece cuando se da por hecho que el aislamiento es total sin revisar cómo se han arrancado.
En resumen
El escape de contenedores Docker existe y tiene nombre propio en el mundo de la seguridad, pero no es algo que ocurra solo por haber entrado en un contenedor. Las vías mejor documentadas dependen de configuraciones arriesgadas, como los contenedores privilegiados o la ausencia de espacios de nombres de usuario, o de fallos de software ya corregidos, como el de runc en 2019. Algunas historias que circulan simplifican cómo funcionan los permisos en Linux y no están respaldadas por casos reales documentados. Revisar la configuración y mantener todo actualizado reduce mucho el riesgo.
Fuentes
- Linux man-pages: proc_pid_root(5)
- Kernel.org: Yama (ptrace_scope)
- Red Hat: CVE-2019-5736
- Red Hat Bugzilla 1664908
- Qualys ThreatPROTECT: CVE-2019-5736
- Frichetten/CVE-2019-5736-PoC (GitHub)
- HackTricks: Docker Breakout / Privilege Escalation
- HackTricks: Docker --privileged
- InfoSec Institute: Securing containers using Docker isolation
- KodeKloud: Container root vs. host root
- StackHarbor: Docker user namespaces
- SecureLayer7: What is a privileged container?
- DEV Community: Container escape techniques
- DevOpsBeast: The root problem in containers
Code Mode de Cloudflare: qué es y cómo ahorra tokens en la IA
Fecha: 2026-11-16 15:46:20Autor: Alex Rubio
Los asistentes de inteligencia artificial ya no se limitan a conversar: cada vez más, también actúan. Consultan una base de datos, crean un pedido o revisan una agenda. Para hacerlo usan herramientas externas, y la forma de conectarlas tiene un coste en dinero y en tiempo. Code Mode de Cloudflare es una propuesta para reducir ese coste: en lugar de usar las herramientas una a una, el modelo escribe un pequeño programa que hace todo el trabajo de una vez y devuelve solo lo necesario.
Junto a esta novedad circula la idea de que Code Mode «ha matado» a MCP, el estándar más extendido para conectar agentes de IA con herramientas. No es así, y entender por qué ayuda a ver hacia dónde va la IA que trabaja por nosotros.
Agentes, herramientas y MCP: lo básico
Un agente de IA es un programa que usa un modelo de lenguaje, como los que hay detrás de los chatbots, para completar tareas. Por sí solo, el modelo solo sabe generar texto. Para hacer algo en el mundo real necesita herramientas: funciones que puede pedir que se ejecuten, como «buscar un cliente» o «crear una factura». Es parecido a un empleado que, cada vez que necesita un dato, se lo pide a otro departamento.
Todo lo que el modelo lee y escribe se mide en tokens, que son fragmentos de texto del tamaño de una palabra o de un trozo de ella. Los tokens marcan el precio de usar la IA y también su capacidad, porque el modelo solo puede tener a la vista una cantidad limitada a la vez. Ese espacio se llama ventana de contexto, y se puede imaginar como una mesa de trabajo: por grande que sea, si la llenas de papeles, ya no cabe nada más.
Aquí entra MCP (Model Context Protocol). Es un estándar abierto que permite a un agente descubrir qué herramientas tiene disponibles y usarlas. Funciona como un enchufe común: cualquier aparato que lo respete se puede conectar. Anthropic lo presentó en noviembre de 2024 y, según la Linux Foundation, en diciembre de 2025 lo cedió al Agentic AI Foundation, un fondo dependiente de esta organización. La propia Linux Foundation cita más de 10.000 servidores MCP publicados.
El problema de las idas y vueltas
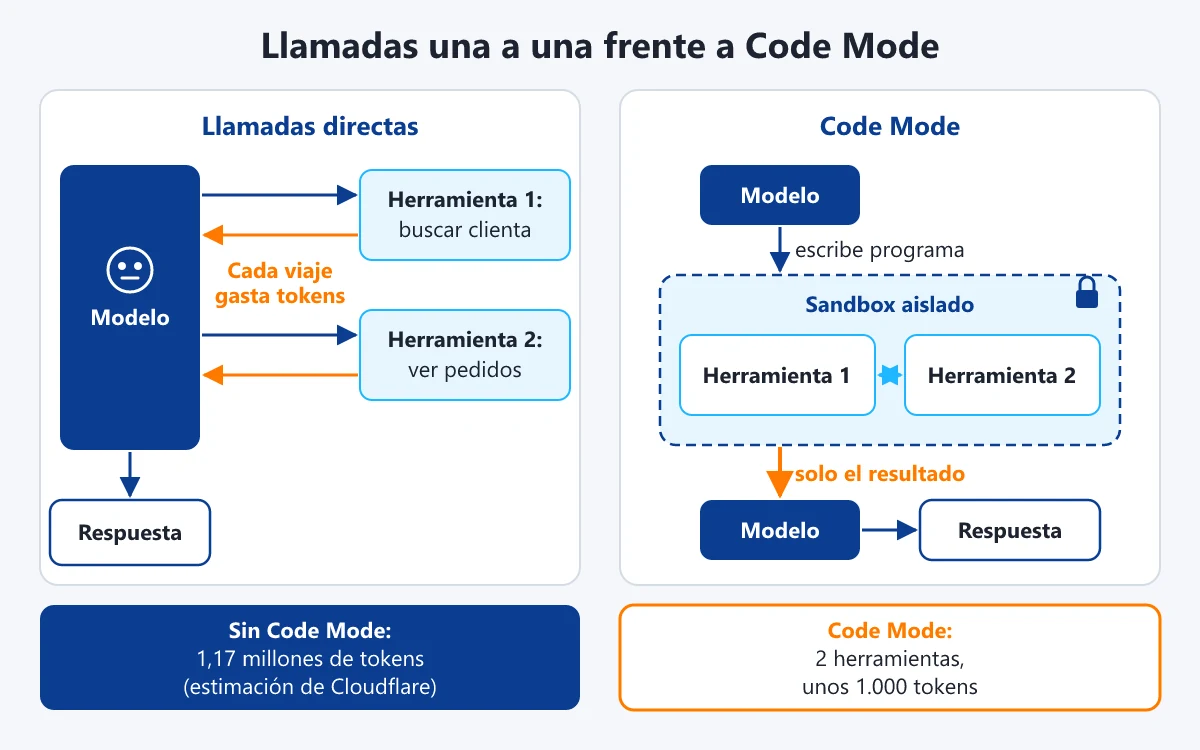
Imagina que le pides a un agente: «Busca a la clienta Ana y dime cuáles son sus últimos pedidos». Con el método tradicional, el modelo llama primero a una herramienta para encontrar a Ana. El resultado vuelve al modelo, que lo lee y decide el siguiente paso. Después llama a otra herramienta para obtener los pedidos, y el resultado vuelve otra vez. Solo entonces redacta la respuesta.
Cada uno de esos viajes tiene un precio. Anthropic explica en su blog de ingeniería que cada llamada a una herramienta exige que el modelo haga una pasada completa de trabajo, y que los resultados intermedios se van acumulando en el contexto. Es como si el empleado tuviera que volver a su mesa, leer el informe entero y luego ir al siguiente departamento, aunque de ese informe solo le interesara una línea.
Hay un segundo problema, menos visible: antes de empezar, el modelo necesita conocer la lista de herramientas disponibles, con la descripción de cada una. Si son pocas, no pasa nada. Pero si son cientos o miles, esa lista ocupa buena parte de la mesa. Anthropic reconoce que, antes de optimizar su sistema, las definiciones de herramientas llegaron a consumir 134.000 tokens por sí solas.
Cómo funciona Code Mode de Cloudflare
La idea de Cloudflare cambia el enfoque. En lugar de presentar al modelo una larga lista de herramientas sueltas, las convierte en una API de TypeScript, un lenguaje de programación muy usado en la web. Según la documentación de Cloudflare, el modelo recibe un conjunto de funciones bien descritas, con los tipos de datos que espera cada una, y escribe código que las utiliza.
Volviendo al ejemplo, el modelo ya no hace dos viajes. Escribe un programa corto que busca a Ana, obtiene su identificador, consulta sus pedidos y prepara un resumen. Es la diferencia entre ir preguntando paso a paso y entregar una receta completa para que alguien la siga de principio a fin.
Ese programa no se ejecuta en cualquier sitio. Según InfoQ, corre en un sandbox, un entorno aislado (en concreto, un V8 isolate, la misma tecnología que usan los navegadores para separar unas páginas de otras). Un sandbox es como una habitación cerrada: el código puede trabajar dentro, pero no tiene acceso al resto del sistema, lo que limita los riesgos. La documentación de Cloudflare añade que al modelo solo le llega el valor final, no todos los datos intermedios.
¿Por qué funcionaría mejor que el método tradicional? Una explicación que se repite es que los modelos de lenguaje han aprendido de enormes cantidades de código real y de muy pocos ejemplos de llamadas a herramientas, así que escribirían programas con más soltura. Es una hipótesis razonable, pero no hemos encontrado ninguna fuente oficial que la confirme, de modo que conviene tomarla como una posible explicación y no como un hecho demostrado.
Las cifras, con sus matices
El ejemplo que usa Cloudflare para mostrar el ahorro es su propia API, que según su blog y su documentación tiene más de 2.500 endpoints. Un endpoint es una dirección concreta de la API que realiza una operación, por ejemplo crear un registro DNS. Si cada uno se ofreciera al modelo como una herramienta independiente, la lista sería gigantesca.
Con Code Mode, el servidor solo expone dos herramientas: una para buscar en la API (search) y otra para ejecutar código (execute). Según el blog de Cloudflare, eso ocupa unos 1.000 tokens, frente a los 1,17 millones que consumiría un servidor equivalente sin Code Mode: una reducción del 99,9 %.
Conviene leer estas cifras con cuidado. El millón largo de tokens no es una medición de un antes y un después real, sino una estimación de lo que ocuparía la lista si cada endpoint fuera una herramienta. Además, el número cambia según cómo se calcule: el repositorio oficial de Cloudflare habla de unos 2 millones de tokens para el esquema completo de la API y de unos 244.000 si las herramientas se describen con los parámetros mínimos. Y la medición de los 1.000 tokens la hace la propia empresa; no hemos encontrado una comprobación independiente. La conclusión de fondo se mantiene, porque el ahorro es enorme con cualquiera de esas referencias, pero la cifra exacta depende del método.
¿Ha matado Cloudflare a MCP?
Se suele decir que Code Mode acaba con MCP, pero en realidad lo utiliza. Según InfoQ y la documentación de Cloudflare, Code Mode se distribuye precisamente como un servidor MCP. El agente se conecta a él por MCP, como a cualquier otro; lo que cambia es lo que ese servidor le ofrece: dos herramientas para escribir y ejecutar programas en lugar de miles de herramientas sueltas.
Cloudflare tampoco es la única que sigue este camino. Anthropic ofrece una función parecida que llama programmatic tool calling (llamadas programáticas a herramientas). El principio es el mismo, que el modelo escriba código que use las herramientas, pero la implementación es distinta: según la documentación de Claude, el código se ejecuta en un contenedor gestionado por Anthropic con un entorno Python, no TypeScript.
Otra idea que circula es que ha terminado la época de llamar a las herramientas de una en una. Esto también es exagerado. Anthropic recomienda decidir, herramienta por herramienta, si se usa de forma directa o mediante código. Y aunque desde el 26 de marzo de 2026 Code Mode viene activado por defecto en los portales de servidores MCP de Cloudflare, según su registro de cambios, se puede desactivar. Para tareas sencillas, de una sola llamada o con pocas herramientas, el método clásico sigue teniendo sentido. Ninguna fuente da un umbral oficial para Code Mode, pero como referencia, Anthropic no recomienda sus herramientas de búsqueda cuando la biblioteca tiene menos de diez herramientas.
¿Y a mí en qué me afecta?
Si usas asistentes de IA en tu día a día, probablemente no notarás Code Mode de forma directa, porque funciona por debajo. Lo que sí puede notarse es el resultado: agentes que completan tareas con menos pasos, con menos esperas y con un coste menor para las empresas que los ofrecen.
Si tienes un negocio o trabajas con agentes conectados a tus sistemas, estas son algunas ideas prácticas:
- Revisa cuántas herramientas expones. Si son muchas, la lista puede estar ocupando una parte importante del contexto y encareciendo cada consulta.
- No lo apliques por defecto a todo. Con pocas herramientas o tareas de un solo paso, las llamadas directas suelen ser suficientes y más sencillas de controlar.
- Cuida el entorno de ejecución. Si el modelo va a escribir y ejecutar código, que sea siempre en un entorno aislado, como hacen Cloudflare y Anthropic.
- Toma las cifras como orientación. Los ahorros publicados dependen de cómo se midan; lo útil es comprobar el gasto de tokens en tu propio caso.
En resumen
Code Mode de Cloudflare es una forma de usar MCP, no su sustituto. En lugar de que el modelo llame a las herramientas una a una y reciba todos los resultados intermedios, escribe un programa que se ejecuta en un entorno aislado y devuelve solo lo que importa. Con su API de más de 2.500 endpoints, Cloudflare calcula que pasa de más de un millón de tokens a unos 1.000, aunque esa cifra es una estimación propia que varía según el método. Anthropic aplica el mismo principio con sus llamadas programáticas, y ambas compañías mantienen las llamadas directas como opción válida para los casos sencillos.
Fuentes
- Cloudflare: Code Mode: give agents an entire API in 1,000 tokens
- Cloudflare: Cloudflare's own MCP servers
- Cloudflare: documentación de Code Mode
- Cloudflare: Code Mode for MCP server portals (registro de cambios)
- GitHub: repositorio oficial cloudflare/mcp
- InfoQ: Cloudflare Launches Code Mode MCP Server
- Anthropic: Advanced tool use
- Anthropic: documentación de Programmatic tool calling
- Linux Foundation: nota sobre MCP y el Agentic AI Foundation
- Wikipedia: Model Context Protocol
Bitcoin no es anónimo: así se rastrea y así se intenta ocultar
Fecha: 2026-11-16 15:43:32Autor: Alex Rubio
Mucha gente piensa que las criptomonedas son dinero invisible, perfecto para quien quiere esconderse. La realidad es casi la contraria: Bitcoin no es anónimo. Cada pago queda apuntado en un registro público que cualquiera puede consultar y que nadie puede borrar. Lo que no aparece en ese registro son los nombres de las personas.
Esa mezcla de transparencia total y ausencia de nombres explica por qué los ciberdelincuentes dedican tanto esfuerzo a dispersar el dinero que cobran, y también por qué, en algunos casos muy conocidos, la policía ha conseguido seguir el hilo y recuperar parte de lo pagado. En este artículo te contamos cómo funciona ese juego del escondite y qué significa para ti.
Bitcoin no es anónimo: es un registro público con seudónimos
Para entenderlo hay que empezar por la cadena de bloques, o blockchain. Es como un gran libro de cuentas compartido por miles de ordenadores: todo el mundo puede leerlo, pero nadie puede arrancar una página ni tachar una línea. Según explica la plataforma 21bitcoin, todas las transacciones de Bitcoin quedan registradas de forma pública y permanente en esa cadena.
En ese libro no se apuntan nombres, sino direcciones: largas ristras de letras y números. Una dirección se parece a un número de cuenta bancaria en el que no figura el titular. Como recuerda la empresa River, esas direcciones no están ligadas por sí mismas a ningún nombre, teléfono ni domicilio, y los usuarios pueden generar direcciones nuevas cuando lo necesiten.
Por eso los especialistas no dicen que Bitcoin sea anónimo, sino seudónimo. La diferencia es importante. Un sistema anónimo esconde tanto quién eres como lo que haces; uno seudónimo enseña todo lo que haces, pero bajo un alias, igual que un escritor que firma sus libros con otro nombre. Y como pasa con los escritores, el seudónimo puede descubrirse: basta con que una dirección se relacione con una persona real, por ejemplo cuando alguien usa una plataforma de cambio que le ha pedido el DNI, para que todo su historial quede a la vista.
Cómo intentan borrar el rastro
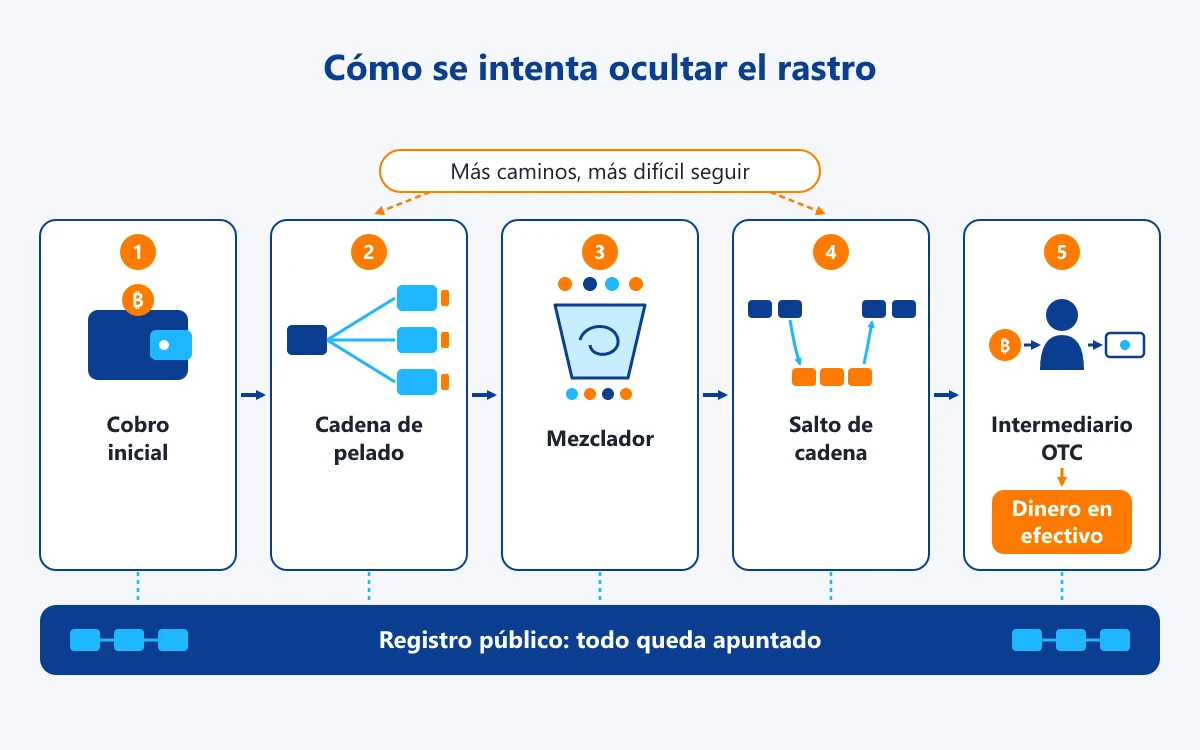
Si todo queda registrado, quien cobra un rescate o roba criptomonedas tiene un problema: el dinero deja huellas. La estrategia habitual no consiste en hacerlas desaparecer, algo imposible, sino en multiplicarlas hasta que seguirlas cueste muchísimo trabajo. Estas son las técnicas más conocidas.
La cadena de pelado
Consiste en ir enviando pequeñas cantidades a direcciones nuevas y pasar el resto a otra dirección, que repite la operación, y así una y otra vez. Es como ir cortando lonchas de un embutido: cada loncha se va por su lado y lo que queda sigue adelante. La firma de análisis Elliptic ha documentado esta técnica en casos reales de robo, en los que los fondos se repartieron mediante una cadena de pelado entre decenas de direcciones.
Los mezcladores
Un mezclador es un servicio que junta el dinero de muchos usuarios y lo devuelve repartido de otra manera. Una revisión académica publicada en arXiv sobre métodos de blanqueo con criptomonedas los describe como servicios que intentan dificultar la identificación del origen de los fondos combinando varias transacciones. La comparación cotidiana sería meter tus billetes en una bolsa con los de cientos de personas y sacar después otros distintos.
El salto entre cadenas
La tercera técnica es cambiar Bitcoin por otras criptomonedas, que funcionan en redes distintas, y a veces volver después a Bitcoin. Es parecido a pasar por varias casas de cambio seguidas para que cueste reconstruir el recorrido. Conviene aclarar dos cosas. La primera, que saltar de una red a otra no es delito en sí mismo: Elliptic, citada por Cybernews, subraya que este cambio no indica por sí solo una actividad ilícita. La segunda, que no siempre rompe el rastro, aunque lo complica: la empresa BlockSec, que ofrece servicios de rastreo, señala que el paso de una red a otra a través de un mezclador es el punto donde los investigadores suelen perder la pista en casos reales.
La salida a dinero normal
Al final, el dinero tiene que convertirse en algo que se pueda gastar. En el análisis de Elliptic sobre un gran robo, recogido por BlockReady, los fondos acabaron llegando a intermediarios que operan fuera de los mercados organizados, lo que se conoce como mesas OTC. Es un patrón observado en ese caso concreto, no una regla que se cumpla siempre.
Cuando el dinero se dispersa por miles de carteras
Se suele decir que, con estas técnicas, unas pocas direcciones se convierten en cientos y después en miles. La idea general es correcta, porque cada reparto abre caminos nuevos, pero no hay una cifra fija que lo mida: cada caso es distinto.
El ejemplo que más se cita es el robo sufrido por la plataforma de cambio Bybit el 21 de febrero de 2025, cuando, según Elliptic, se sustrajeron criptomonedas por valor de unos 1.460 millones de dólares. A menudo se afirma que lo robado acabó repartido en más de 35.000 carteras. Ese dato aparece en BlockReady, que lo atribuye al consejero delegado de Bybit, pero no hemos encontrado el comunicado original que lo confirme, así que hay que tomarlo con cautela.
También es frecuente leer que aquel fue el mayor robo de la historia. Así lo calificó Elliptic en su momento, pero el dato ha quedado superado: según The Washington Post, en octubre de 2026 Binance informó de que un ataque había afectado a fondos de usuarios por valor de unos 6.300 millones de dólares, lo que el periódico describió como probablemente el mayor robo de monedas digitales registrado.
El caso Colonial Pipeline: la cadena no olvida
Si hay un ejemplo que demuestra que Bitcoin no es anónimo, es el de Colonial Pipeline, una gran red de oleoductos de Estados Unidos que en 2021 sufrió un ataque de ransomware, un tipo de programa que bloquea los sistemas de una empresa hasta que paga un rescate. La compañía pagó al grupo DarkSide unos 75 bitcoins, que entonces valían alrededor de 4,4 millones de dólares, según Fast Company (CBS News habla de unos 4,3 millones).
Poco después, el FBI recuperó 63,7 de esos bitcoins tras obtener una orden judicial de incautación. Según CBS News, en el momento de la incautación valían unos 2,3 millones de dólares; la diferencia con lo pagado se explica porque el precio del bitcoin en dólares cambia con el tiempo. De acuerdo con el Departamento de Justicia de EE. UU., recogido por GovInfoSecurity, los investigadores siguieron varias transferencias revisando el registro público de Bitcoin hasta dar con la dirección donde estaba el dinero.
Encontrar la dirección no basta: para mover los fondos hace falta su clave privada, que funciona como la llave de una caja fuerte. Cómo consiguió el FBI esa clave no se ha aclarado públicamente. Lo que sí descartaron expertos consultados por Vice es que el Gobierno hubiera roto el cifrado de Bitcoin. GovInfoSecurity destaca además otro factor clave: Colonial avisó muy pronto a las autoridades, lo que permitió actuar a tiempo.
¿Y a mí en qué me afecta?
Aunque no tengas criptomonedas, este tema te toca más de lo que parece. Los rescates de ransomware afectan también a pequeñas empresas, y entender cómo se mueve ese dinero ayuda a tomar mejores decisiones. Algunas ideas prácticas:
- No confundas seudónimo con privacidad. Si usas Bitcoin, todo tu historial de pagos es público. Si alguien relaciona una de tus direcciones contigo, podrá ver tus movimientos.
- Avisa pronto a las autoridades. Si tu empresa sufre un ataque o una estafa con criptomonedas, el caso Colonial muestra que la rapidez en la denuncia puede marcar la diferencia.
- Desconfía de quien te pida pagar en criptomonedas con urgencia. No es una prueba de fraude por sí sola, pero recuperar ese dinero es difícil y depende de una investigación compleja.
- Protege lo que te hace vulnerable. Copias de seguridad, actualizaciones y contraseñas robustas siguen siendo la mejor defensa para no llegar nunca a la situación de tener que pagar un rescate.
En resumen
Bitcoin no es anónimo, sino seudónimo: no guarda nombres, pero apunta para siempre cada movimiento en un registro público. Quienes quieren esconder dinero lo trocean, lo mezclan y lo cambian de red para que seguirlo sea lento y caro, y a veces lo consiguen. Pero el rastro sigue ahí, y casos como el de Colonial Pipeline demuestran que, con tiempo, colaboración y una denuncia rápida, ese registro puede acabar llevando hasta el dinero.
Fuentes
- GovInfoSecurity: $2.3 Million of Colonial Pipeline Ransom Payment Recovered
- CBS News: U.S. recovers $2.3 million in ransom paid to Colonial Pipeline hackers
- Fast Company: Stolen bitcoin is hard to get back, but the FBI says it just did it
- Vice: How Did the Feds Seize the Colonial Pipeline Ransomware Bitcoins?
- Bloomberg (vía Chron): Colonial Pipeline's Bitcoin Ransom Mostly Recouped by U.S.
- Elliptic: Following the money trail from the Bybit hack
- Elliptic: North Korea likely behind the Binance hack
- The Washington Post: Massive crypto hack probably the largest theft of digital currencies in history
- Cybernews: Crypto criminals increasingly go chain-hopping to launder money
- arXiv: A Review on Cryptocurrency Transaction Methods for Money Laundering
- BlockReady: The Bybit Hack Explained
- BlockSec: Trace Stolen Crypto Through a Mixer
- 21bitcoin: Bitcoin and anonymity
- River: Is bitcoin anonymous?
- Wikipedia: Blockchain privacy
- Wikipedia: Blockchain
Ingeniería inversa con IA: así funciona BLA, la defensa con trampas
Fecha: 2026-11-14 16:31:22Autor: Alex Rubio
La ingeniería inversa con IA ha pasado en pocos meses de ser una curiosidad de especialistas a algo que cualquiera con cierta soltura técnica puede probar en su propio ordenador. Herramientas gratuitas como REA permiten que un agente de inteligencia artificial examine un programa ya terminado e intente explicar cómo funciona por dentro. Y, como suele ocurrir en seguridad informática, en cuanto aparece una forma nueva de atacar aparece también alguien que intenta frenarla.
En este caso, ese alguien es BLA, un proyecto de código abierto que propone una defensa poco habitual: en lugar de esconder el código, lo llena de pistas falsas para que la IA se pierda por el camino. A continuación te contamos qué hacen exactamente estas dos herramientas, qué hay de cierto en lo que se dice de ellas y qué cifras conviene leer con prudencia.
Qué es la ingeniería inversa con IA y qué hace REA
La ingeniería inversa consiste en estudiar cómo funciona un programa sin tener su código fuente, es decir, sin las instrucciones originales que escribieron sus autores. Es como desmontar un reloj ya montado para entender su mecanismo sin tener los planos. Durante años ha sido un trabajo lento y manual, reservado a analistas con mucha experiencia.
REA (siglas de Reverse Engineer Anything, algo así como «ingeniería inversa de cualquier cosa») busca que parte de ese trabajo lo haga un agente de IA, es decir, un modelo de inteligencia artificial capaz de usar herramientas externas por su cuenta. Según la reseña publicada en Buttondown, el proyecto se publicó en GitHub el 14 de abril de 2026 con licencia MIT, una licencia que permite usarlo y modificarlo gratis. Funciona como un servidor MCP y como herramienta de línea de comandos. MCP es un estándar abierto que permite a los agentes de IA conectarse a otras herramientas, algo así como un enchufe universal para que la IA pueda manejar programas ajenos.
Con ese enchufe, el agente pone a trabajar en el ordenador del usuario descompiladores conocidos como Ghidra, IDA, Hopper o JADX. Un descompilador intenta reconstruir un código legible a partir de un programa ya compilado, igual que alguien que intentara deducir una receta probando el plato terminado. Según su repositorio oficial, REA sirve para inspeccionar programas nativos, aplicaciones hechas con JavaScript y Electron (la tecnología con la que se construyen muchos programas de escritorio a partir de tecnologías web), ensamblados .NET y sitios web. Su popularidad se disparó: según PiyushAI, pasó de menos de 10.000 a cientos de miles de estrellas en GitHub durante octubre de 2026, aunque el número exacto varía según la fuente que se consulte.
Se suele decir que, con esto, un agente de IA puede desarmar casi cualquier programa y que es muy fácil. Es una exageración. Como explica Buttondown, REA no convierte a la IA en un descompilador autosuficiente: hace falta tener instaladas las herramientas de análisis, proporcionar al agente un programa que se esté autorizado a analizar y plantearle una pregunta de investigación concreta. Tampoco hay pruebas de que pusiera nerviosa a buena parte de la industria: lo que recoge AICoder es un debate intenso entre desarrolladores en X, sin fuentes que documenten reacciones de empresas.
Por qué la ofuscación tradicional podría quedarse corta
La forma clásica de proteger un programa que se distribuye es la ofuscación: hacer el código difícil de leer, por ejemplo cambiando los nombres de las variables por letras sin sentido o enredando su estructura. Es como escribir una carta en un idioma que solo entiende quien tiene la clave. Funciona porque a una persona le cuesta mucho tiempo y paciencia descifrar ese galimatías.
Quienes defienden enfoques como el de BLA sostienen que esa barrera pierde eficacia cuando quien lee el código es una IA, porque los modelos reconocen patrones con rapidez y no se cansan. También se repite que durante décadas se protegió el código pensando solo en lectores humanos. Son opiniones razonables, pero no las hemos podido contrastar con estudios o datos independientes, así que conviene leerlas como argumentos del debate y no como hechos demostrados.
Cómo funciona BLA: envenenar, agotar y alucinar
BLA son las siglas de Blind LLM Agents, que podría traducirse como «agentes de IA a ciegas». Según su repositorio oficial, la idea no es ocultar el código, sino conseguir que la IA lo interprete mal y se quede sin presupuesto antes de entender nada útil. Hay un matiz importante: BLA no toca los archivos fuente con los que trabajan los programadores, sino los artefactos de compilación, que son la versión final del programa que se entrega a los usuarios.
Para entender la estrategia hay que hablar de los tokens. Un token es un fragmento de texto que la IA procesa y por el que normalmente se paga. Cuanto más código tiene que leer y razonar un agente, más tokens consume y más dinero cuesta el análisis, como un taxi cuyo taxímetro sigue corriendo mientras el conductor da vueltas. BLA quiere que ese taxímetro no pare.
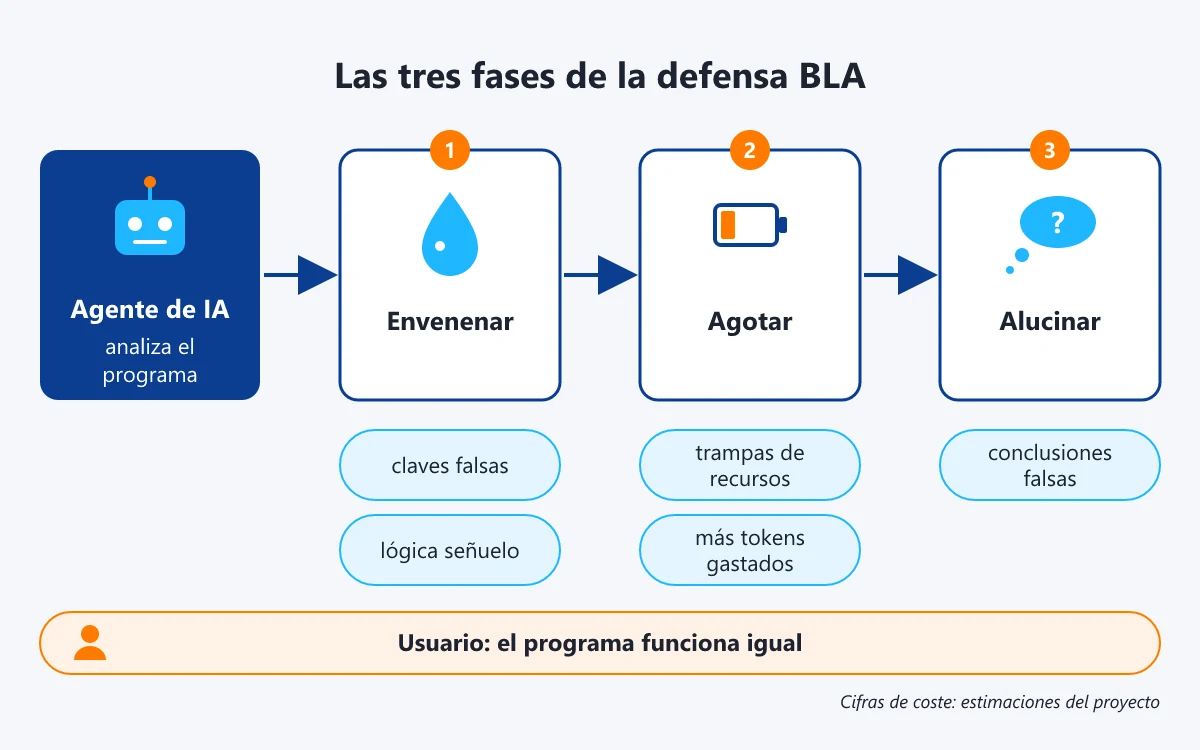
El proyecto resume su método en un lema de tres pasos:
- Envenenar: sembrar el programa de señuelos, como claves falsas y lógica que parece importante pero no hace nada útil.
- Agotar: colocar trampas de recursos que obligan al agente a gastar tokens en caminos sin salida y a repartir su atención entre hipótesis que se contradicen.
- Alucinar: lograr que la IA acabe sacando conclusiones sobre un funcionamiento que en realidad no existe.
Estos señuelos funcionan como lo que en seguridad se llama un honeypot o trampa: un cajón con una llave falsa que hace perder el tiempo a quien intenta abrirlo. Eso sí, la descripción de estas trampas procede del propio proyecto y no hemos encontrado pruebas independientes que confirmen cómo se comportan frente a agentes reales.
BLA se distribuye a través de npm, el gran almacén de paquetes de JavaScript, con el nombre bla-agents, y su repositorio indica que es compatible con asistentes como Claude Code, Codex, Cursor y Gemini CLI, entre otros. El número de formatos de archivo que puede proteger varía según la fuente: unas hablan de más de 19 y otras de 26. Su crecimiento también ha sido rápido: según i10x, el repositorio se creó el 25 de octubre de 2026 y el 9 de noviembre ya tenía 3.887 estrellas y 478 copias derivadas (forks). Se ha dicho que alcanzó casi 4.000 estrellas en seis semanas, pero en realidad le bastaron unos quince días.
Las cifras: lo que dice el proyecto y lo que está comprobado
El dato más llamativo de BLA es que el atacante gastaría entre 300 y 2.800 veces más tokens al analizar un programa protegido. Conviene leerlo con mucho cuidado. Como explica ExplainX, el propio proyecto presenta esos importes en tokens y en dólares como estimaciones internas, no como mediciones. La suma total de su propia tabla da unas 639,5 veces más tokens y unas 304,4 veces más coste, y otra fuente recoge un rango distinto, de 162 a 2.532 veces, lo que indica que las cifras no son estables.
Las pruebas reales que el proyecto ha hecho contra REA miden otra cosa: cuántas veces falla el analizador, no cuánto se multiplica el gasto. Son datos útiles, pero no equivalen a demostrar el multiplicador de coste. En nuestra búsqueda no hemos encontrado ninguna verificación independiente de esas cifras.
Algo parecido ocurre con la promesa de que el programa funciona exactamente igual para el usuario. El proyecto afirma una equivalencia del 100 % en tiempo de ejecución, es decir, que el programa se comporta igual aunque por dentro esté modificado, pero ese resultado se refiere a sus 14 objetivos de prueba. No hay datos sobre aplicaciones reales de terceros. Además, las trampas ocupan espacio: en la prueba del propio proyecto, un archivo de una aplicación Electron pasó de 607 bytes a 16,9 MiB. Por eso la reseña de Review Ramble señala que el coste real para quien lo usa son descargas más grandes y más tiempo para verificar cada versión.
¿Es realmente un antídoto contra la ingeniería inversa con IA?
Presentar BLA como el antídoto definitivo es quedarse corto en matices. Como explica Starlog, su protección es económica y no criptográfica: no hace el análisis imposible, solo intenta hacerlo caro. Un atacante con mucho presupuesto puede, sencillamente, pagar ese coste extra en tokens. Es como una puerta muy pesada: disuade a muchos, pero no detiene a quien está dispuesto a empujar el tiempo suficiente.
Review Ramble añade que un analista humano decidido sigue pudiendo superar la protección, ya que las trampas están pensadas sobre todo para confundir a los agentes automáticos. Y en el debate entre desarrolladores se ha recordado que una herramienta así no sustituye a las comprobaciones que se hacen en el servidor ni a una buena gestión de las claves. Dicho de otro modo, BLA puede ser una capa más, pero no la cerradura principal.
¿Y a mí en qué me afecta?
Si eres usuario de aplicaciones, lo más probable es que no notes nada a simple vista. Si algún programa que usas adopta este tipo de protección, el cambio más visible podría ser que sus descargas ocupen bastante más. Si desarrollas o encargas software, en cambio, hay algunas ideas sencillas que conviene tener presentes:
- No guardes secretos dentro de la aplicación: las claves importantes y las comprobaciones críticas deben vivir en el servidor, no en el programa que se descarga el usuario.
- Trata las cifras con cautela: los multiplicadores de coste de BLA son estimaciones del propio proyecto, no mediciones independientes.
- Prueba tu propio programa: la equivalencia del 100 % se ha comprobado en 14 casos de prueba, así que verifica que todo funciona igual en el tuyo y vigila el tamaño final.
- Instala solo desde las fuentes oficiales: hay muchas copias del repositorio, y el proyecto pide usar siempre qybaihe/bla o el paquete bla-agents. En el caso de REA, la fuente oficial es github.com/morluto/rea.
- Analiza solo lo que tengas permiso para analizar: el propio planteamiento de REA parte de trabajar con programas autorizados.
En resumen
La ingeniería inversa con IA es ya una realidad práctica gracias a herramientas como REA, aunque no es tan automática ni tan sencilla como a veces se cuenta. BLA responde con una idea original: dejar el código a la vista, pero sembrado de señuelos que hagan que la IA gaste más, se equivoque y saque conclusiones falsas. Su enfoque es interesante, pero sus cifras más llamativas son estimaciones propias sin verificación independiente, su protección es económica y no absoluta, y no sustituye a las buenas prácticas de siempre, como mantener los secretos fuera del programa que se distribuye.
Fuentes
- GitHub: qybaihe/bla (repositorio oficial de BLA)
- bla.tools (web oficial de BLA)
- GitHub: morluto/rea (repositorio oficial de REA)
- Buttondown: Reverse Engineer Anything (REA) on GitHub: How Far It Goes
- PiyushAI: REA (Reverse Engineer Anything) Explained
- i10x: BLA (Blind LLM Agents) vs. REA
- GitHot: qybaihe/bla
- AICoder: debate sobre BLA en X
- ExplainX: BLA Blind LLM Agents, 612x Token Claim, Checked
- Review Ramble: reseña de BLA
- Starlog: BLA, The First Adversarial Defense System Built to Bankrupt AI Reverse Engineering
Claude Fable 5.2: qué puede hacer y cuándo merece la pena usarlo
Fecha: 2026-11-14 15:12:24Autor: Alex Rubio
Anthropic, la empresa que desarrolla el asistente de inteligencia artificial Claude, presentó el 9 de noviembre de 2026 Claude Fable 5.2, su modelo pensado para los trabajos técnicos más ambiciosos. El lanzamiento ha llegado con demostraciones llamativas: miles de agentes trabajando a la vez, un sistema operativo creado a partir de una carpeta vacía y dispositivos electrónicos diseñados con ayuda de la máquina.
Detrás de los titulares hay una pregunta más práctica: ¿le compensa a una persona normal, o incluso a un programador, usar el modelo más grande para el trabajo de cada día? Para la mayoría de tareas, no hace falta. En este artículo explicamos qué es Claude Fable 5.2, qué ha conseguido según la propia empresa, qué parte de lo que se cuenta está exagerada y cuándo tiene sentido pagarlo.
Qué es Claude Fable 5.2 y dónde encaja
Un modelo de lenguaje es un programa entrenado con enormes cantidades de texto que aprende a generar respuestas, escribir código o razonar sobre un problema. Anthropic organiza los suyos en cuatro niveles, según recoge Wikipedia: Fable, Opus, Sonnet y Haiku. Se parece a la gama de una marca de coches: todos llevan al destino, pero cambian la potencia y el precio.
Fable es el escalón más alto. Junto a él se presentó Claude Mythos 5.2, que no está abierto al público: según el anuncio oficial, queda limitado a organizaciones que participan en los programas de verificación de Anthropic en ciencias de la vida y ciberseguridad. Fable 5.2, en cambio, está disponible en todos los planes de pago de Claude, según la cuenta oficial del asistente, además de en la plataforma para desarrolladores y en las principales nubes. Eso sí, cuánto se puede usar depende del plan contratado.
Según la documentación oficial, el modelo puede manejar un contexto de un millón de tokens y generar hasta 128.000 tokens de respuesta. Un token es un fragmento de texto, más o menos una palabra o un trozo de ella. El contexto es la cantidad de información que el modelo puede tener presente a la vez, algo así como el tamaño de la mesa sobre la que extiende sus papeles.
Más rápido y más barato que su predecesor, pero no que Opus
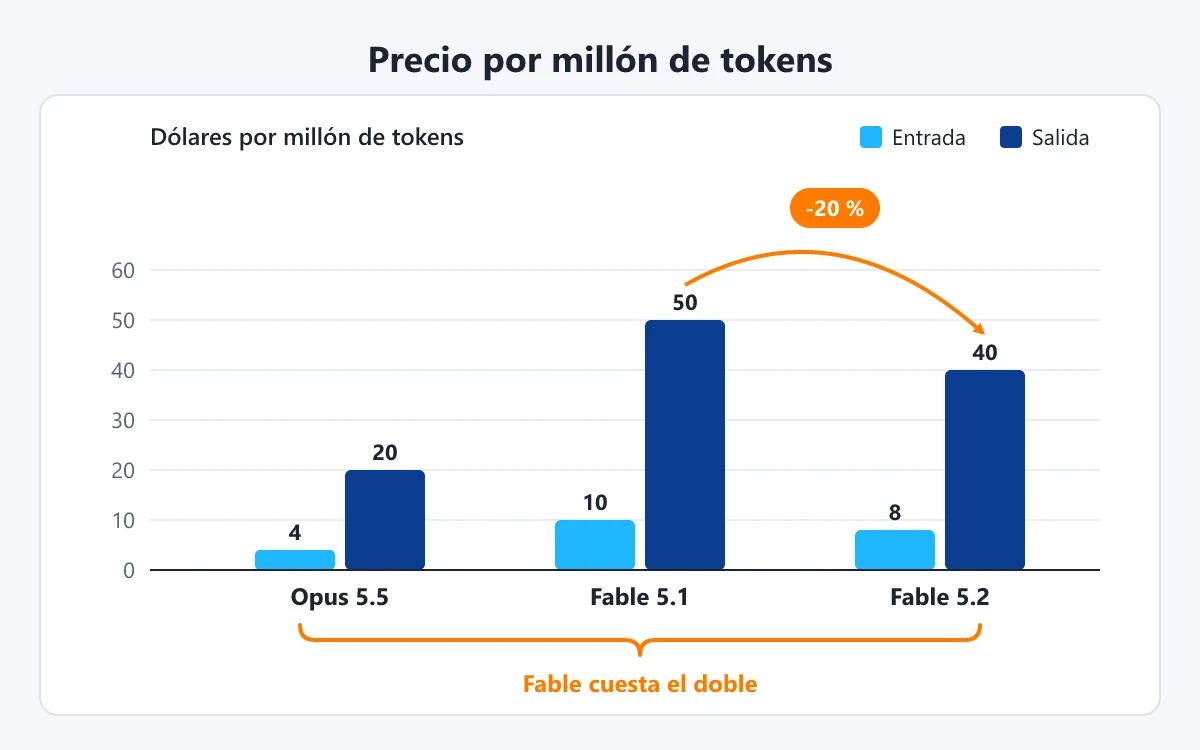
Estos modelos se pagan por millón de tokens, de forma parecida a como se compra fruta al peso: se cobra lo que entra (la petición) y lo que sale (la respuesta). Según The Next Web, Fable 5.2 cuesta 8 dólares por millón de tokens de entrada y 40 por millón de salida, frente a los 10 y 50 de Fable 5.1. Es una rebaja del 20 % en ambos casos. Anthropic añade que genera resultados hasta un 30 % más rápido que la versión anterior.
La comparación cambia cuando se mira hacia abajo en la gama. La documentación oficial fija el precio de Opus 5.5 en 4 y 20 dólares por millón de tokens, exactamente la mitad que Fable 5.2. Por eso Anthropic recomienda empezar con Opus 5.5 para la mayoría de tareas de programación y de trabajo con información, y pasar a Fable o Mythos cuando el encargo es más complejo. A veces se resume como que la empresa desaconseja usar Fable, pero el consejo completo es reservarlo para cuando el problema lo requiera.
¿Es el modelo más potente que existe?
Se ha repetido que Fable 5.2 supera a Opus en prácticamente todas las pruebas y que es el número uno del mercado. Conviene matizarlo. Anthropic afirma que el modelo está un escalón por encima de Opus 5.5 en casi todas las capacidades evaluadas y pone ejemplos como FrontierCode 2.0, una prueba de programación en la que Fable 5.2 obtiene un 49,1 % frente al 45,5 % de Opus 5.5. Estas pruebas estandarizadas, llamadas benchmarks, funcionan como un examen común para comparar modelos, pero sus resultados dependen de las condiciones y, cuando los publica la propia empresa, no son una evaluación independiente.
Además, la ventaja no es uniforme. En las pruebas iniciales de Anthropic, Fable 5.2 con un nivel de esfuerzo alto rindió al nivel de Opus 5.5 con esfuerzo máximo, aunque con aproximadamente la mitad de coste por tarea. En cuanto a ser el número uno, la ficha del modelo en Artificial Analysis, una web que compara modelos, existe, pero no hemos podido confirmar que lo sitúe en primera posición. Anthropic lo presenta como su modelo más potente, que no es lo mismo que el más potente del mercado.
Las demostraciones de Claude Fable 5.2: qué hizo de verdad
Gran parte de la atención se la han llevado los ejemplos que Anthropic eligió para mostrar el modelo. Casi todos se basan en agentes: modelos que trabajan por su cuenta durante varios pasos, escribiendo código, probándolo y corrigiéndolo. Cuando hay muchos a la vez, uno hace de jefe de obra que reparte tareas y los demás, los subagentes, son las cuadrillas. Merece la pena repasar cada caso con calma, porque al contarse de boca en boca algunos han ido creciendo.
El último teorema de Fermat
Anthropic asegura que 1.000 agentes de Fable 5.2 formalizaron en 30 horas, con mínima intervención humana, la demostración del último teorema de Fermat en Lean. Formalizar no es descubrir: el teorema lo demostraron Andrew Wiles y Richard Taylor en los años noventa. Lo que se hace es traducir esa demostración a un lenguaje que un ordenador puede comprobar paso a paso, como revisar una receta ingrediente por ingrediente para asegurarse de que no falta nada.
El dato de las 30 horas suele contarse sin un antecedente importante: la formalización completa ya existía. El 4 de septiembre de 2026, Anthropic publicó que agentes de Claude habían producido 13 millones de líneas de código Lean para obtener una prueba verificada por ordenador, un trabajo que les llevó 11 días, según Techstrong.ai. Kevin Buzzard, matemático del Imperial College de Londres que dirige desde 2024 un proyecto comunitario para formalizar el mismo teorema, revisó aquella prueba y la calificó de logro notable, según The Next Web. Otro matemático de la misma línea señaló que no se trata de matemática nueva.
Un sistema operativo desde una carpeta vacía
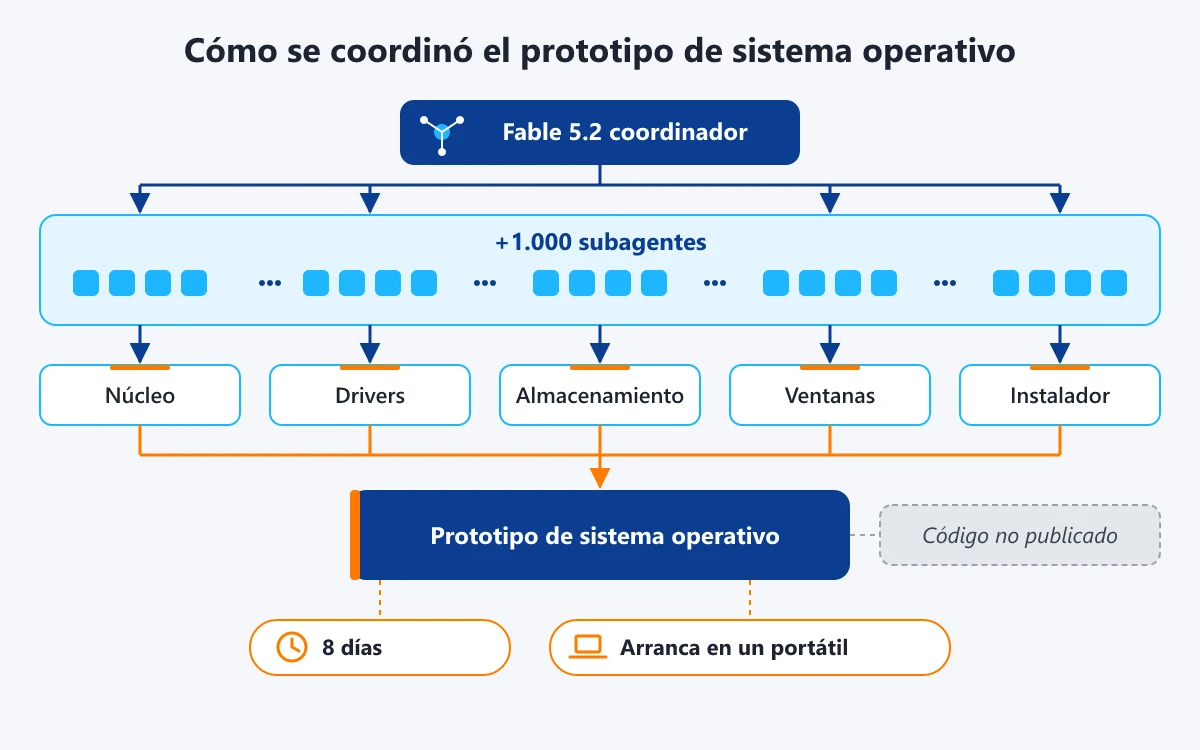
Según la empresa, Fable 5.2 coordinó a más de 1.000 subagentes durante ocho días y obtuvo un prototipo de sistema operativo que arranca en un portátil. El sistema operativo es el programa base de un ordenador, como Windows; su núcleo (kernel) gestiona los recursos, y los drivers son los traductores que le permiten entenderse con el disco, el teclado o la red. Las fuentes mencionan un núcleo propio, drivers de disco, teclado y red, almacenamiento persistente, ventanas, pantalla de inicio e instalador.
Hay dos matices. Era un prototipo, no un sistema listo para usar, y el código no se ha publicado, de modo que se conocen pocos detalles. Tampoco hemos encontrado ninguna mención a un cargador de arranque (bootloader), el pequeño programa que pone en marcha el equipo, así que decir que el modelo lo hizo prácticamente todo es una exageración.
Tres dispositivos electrónicos
La parte de hardware es la que más se ha comentado. Anthropic explica que sus modelos ayudaron a sus ingenieros a diseñar desde cero tres dispositivos electrónicos que funcionan, en colaboración con la empresa de circuitos Diode: un concentrador para asistente de voz, un altavoz USB y una mascota virtual de bolsillo. La palabra clave es «ayudaron». Circula la idea de que la IA lo hizo todo a partir de una sola petición, desde la carcasa en 3D hasta el firmware (el programa grabado en el aparato, como el software de fábrica de una lavadora), y que todo funcionó a la primera. No hemos encontrado nada de eso en las fuentes consultadas.
De Python a Rust
El último ejemplo es más terrenal. Según Anthropic, un equipo de agentes con una versión previa de Fable 5.2 reescribió un servicio de producción crítico, pasándolo de Python, un lenguaje cómodo de escribir pero más lento, a Rust, más exigente pero más eficiente. El servicio arranca ahora unas 26 veces más rápido. La cifra se refiere al tiempo de arranque, no a que el servicio haga todo su trabajo 26 veces más deprisa.
¿Y a mí en qué me afecta?
Para la mayoría de personas, Claude Fable 5.2 no cambiará mucho el día a día. Responder correos, resumir documentos, escribir una función o montar una página web son tareas que los modelos intermedios ya resuelven bien, y por eso la propia Anthropic sugiere empezar por Opus 5.5. Fable está pensado para encargos largos y abiertos, en los que, según la empresa, también puede actuar como asesor de modelos más pequeños o como coordinador que les delega las tareas sencillas.
Algunos consejos sencillos para sacarle partido sin gastar de más:
- Empieza por el modelo intermedio y sube a Fable solo si el resultado no es suficiente.
- Fíjate en el coste por tarea, no solo por token: en las pruebas iniciales de Anthropic, Fable con esfuerzo alto salió más barato por tarea que Opus a máximo esfuerzo.
- Revisa tu plan: el modelo está en todos los planes de pago, pero el uso disponible varía de uno a otro.
- Lee las demostraciones con cautela: casi todos los datos proceden de Anthropic y, por ahora, no hemos encontrado verificación independiente.
También es útil saber que, según Anthropic, el nuevo modelo bloqueó un 55 % menos de peticiones inofensivas que Fable 5.1 en sus pruebas iniciales, lo que debería traducirse en menos negativas innecesarias. Como contexto, el lanzamiento llega poco antes de la salida a bolsa de la empresa, prevista para este mes, según Yahoo Finance.
En resumen
Claude Fable 5.2 es el modelo más potente de Anthropic, un 20 % más barato y hasta un 30 % más rápido que su predecesor, aunque cuesta el doble que Opus 5.5. Sus demostraciones son reales según la empresa, pero con matices que a menudo se pierden: la formalización de Fermat ya existía, el sistema operativo era un prototipo de ocho días, los dispositivos se diseñaron con ingenieros y el dato de 26 veces se refiere al arranque de un servicio. No hemos podido confirmar que sea el número uno del mercado. Para el trabajo diario basta con un modelo intermedio; Fable tiene sentido cuando el problema es grande, largo y complejo.
Fuentes
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2
- Claude Platform Docs: Fable 5.2
- Cuenta oficial de Claude en X (9 de noviembre de 2026)
- MacRumors: Anthropic Launches Claude Fable 5.2 and Mythos 5.2
- The New Stack: Anthropic launches Fable 5.2 with a price cut and stronger coding scores
- The Next Web: Anthropic launches Claude Fable 5.2 and Mythos 5.2, and cuts Fable's price
- Yahoo Finance: Anthropic debuts Claude Fable 5.2 and Mythos 5.2 models as IPO nears
- Benzinga: Anthropic's New AI Can Design Hardware, Find Cybersecurity Flaws And Solve Physics Problems
- Artificial Analysis: ficha de Claude Fable 5.2
- Techstrong.ai: los agentes de Claude formalizan el último teorema de Fermat en 11 días
- The Next Web: reacción de Kevin Buzzard a la formalización de Fermat
- Interesting Engineering: el sistema operativo y la migración de Claude Fable 5.2
- IT-Connect: Claude Fable 5.2 built an operating system in 8 days with 1,000 subagents
- Wikipedia: Anthropic
La dimisión de Jensen Huang en Nvidia: qué se sabe y qué no
Fecha: 2026-11-13 17:10:32Autor: Alex Rubio
La dimisión de Jensen Huang como consejero delegado de Nvidia es una de las noticias empresariales más llamativas del año. Huang cofundó la compañía en 1993 y la ha dirigido desde entonces, hasta convertirla en el gran fabricante de chips para inteligencia artificial. El 12 de noviembre de 2026, Nvidia comunicó que dejaba la presidencia, la dirección ejecutiva y su puesto en el consejo de administración con efecto inmediato, según el formulario 8-K que la empresa presentó ante la SEC, el regulador de la bolsa estadounidense.
Detrás de esta salida se mezclan la vida privada de un directivo, sospechas de espionaje y la pugna entre Estados Unidos y China por los chips más avanzados. Muchas de las cosas que circulan estos días son ciertas, pero otras están exageradas o no se han confirmado. Aquí te contamos qué se sabe con seguridad, qué sigue en el aire y por qué el caso importa más allá de Nvidia.
Quién es Jensen Huang y por qué su salida importa
Huang, nacido en 1963, cofundó Nvidia en abril de 1993 y ha sido su presidente y consejero delegado desde entonces, tal y como recogen los informes anuales de la empresa ante la SEC. Durante años, Nvidia fue conocida sobre todo por sus tarjetas gráficas para videojuegos. Con el auge de la inteligencia artificial, sus chips se convirtieron en la pieza básica de los centros de datos donde se entrenan y se ejecutan los modelos de IA.
Para hacerse una idea del tamaño de la compañía: al cerrarse la etapa de Huang, Nvidia tenía una valoración de unos 5 billones de dólares, según VnExpress. Por eso cualquier sobresalto en su cúpula se nota en los mercados. De acuerdo con Axios, las acciones llegaron a caer hasta un 13 % tras el anuncio antes de recuperar parte del terreno, y Yahoo Finance informó de que el valor se recuperó el viernes después de la caída del jueves.
Cronología de la dimisión de Jensen Huang
Todo se precipitó en pocos días. El domingo 8 de noviembre, Huang admitió en un mensaje interno una relación extramatrimonial, según ABC News y Axios. La mujer es Alice Huang, una de las dirigentes de Megaspeed, una empresa con sede en Singapur, según CBS News y Gizmodo. A pesar de compartir apellido, no tiene parentesco con él, como recoge la entrada de Wikipedia dedicada al escándalo. En algunas versiones que circulan su nombre aparece mal escrito; el correcto es Alice Huang.
Al mismo tiempo, el consejo de administración anunció una investigación independiente. El consejo es el órgano que supervisa a la dirección y que puede destituir al consejero delegado: algo así como la junta que vigila al capitán de un barco. Según NBC News, la investigación se encargó a un comité de consejeros independientes con asesores externos, y Variety informa de que Nvidia contrató al bufete Wachtell, Lipton, Rosen & Katz. En su comunicado, el consejo dijo no tener motivos para pensar que se hubieran comprometido secretos de seguridad nacional o de la empresa, y expresó su confianza en Huang, según NBC News y Axios. En ese momento todo apuntaba a que seguiría en el cargo.
El miércoles 11, The New York Times publicó que Huang había mantenido otra relación, esta vez con una vicepresidenta de Nvidia que dependía directamente de él, según la cronología elaborada por TechCrunch. Ni Nvidia, ni Huang, ni la ejecutiva han confirmado esa información. Después, Reuters informó de otra supuesta relación con una empleada no identificada, que tampoco está confirmada. Se ha repetido que entre la primera noticia y la segunda pasaron dos días, pero según las fechas publicadas fueron tres: del domingo al miércoles.
La salida llegó enseguida. TechCrunch señala que, según una presentación ante la SEC, el consejo aceptó la dimisión el mismo miércoles, y el anuncio público se hizo el jueves 12.
¿Se fue por las relaciones? Lo que dice (y lo que no dice) Nvidia
Se suele resumir la historia diciendo que Huang se marcha por sus relaciones extramatrimoniales. Es la explicación que dan las informaciones periodísticas, y él mismo reconoció la primera relación. Sin embargo, conviene precisar que Nvidia no dio ningún motivo en su anuncio oficial ni mencionó ninguna de las relaciones, como destacan Axios y PBS.
El formulario 8-K es el comunicado obligatorio que una empresa cotizada en Estados Unidos envía al regulador cuando ocurre algo relevante, como un cambio de consejero delegado. En este caso, el documento informa del relevo, pero no explica sus causas. Eso no significa que la causa sea otra: significa que la conexión entre los hechos y la dimisión la establecen los medios, no la empresa, mientras la investigación interna sigue abierta.
Megaspeed y la sospecha de espionaje: qué está probado
La parte más delicada del caso es Megaspeed. Según The New York Times, citado por CBS News, esta empresa compró chips de Nvidia por valor de casi 5.000 millones de dólares en los últimos tres años; CNBC recoge una cifra de más de 4.800 millones desde junio de 2024. La compañía niega haber cometido irregularidades.
Para entender por qué preocupa, hay que hablar de los controles de exportación: las normas del Gobierno de Estados Unidos que limitan qué chips avanzados pueden venderse a China. Funcionan como una aduana muy estricta para un tipo concreto de mercancía. Megaspeed está siendo investigada por funcionarios estadounidenses por sus vínculos con China, según el resumen que TipRanks hace de la información del diario neoyorquino. La duda es si actuaba como intermediaria, es decir, una empresa que compra en nombre de otra para que el producto acabe en un destino al que no podría llegar directamente. Según Gizmodo, en el Gobierno estadounidense se debate por qué no se ha prohibido a Megaspeed recibir envíos de chips de Nvidia.
Sobre Alice Huang, se ha llegado a afirmar que pasó información a los servicios de seguridad chinos. Eso va más allá de lo publicado. Lo que informó The New York Times, según CBS News, es que la inteligencia estadounidense sospecha que es agente del Ministerio de Seguridad del Estado chino. Axios añade que el diario la describe como alguien reclutada para obtener información y para presionar a favor de que se permitan chips avanzados en China. China niega que fuera agente y no hay ninguna confirmación oficial de que transmitiera información. Lo que sí está documentado, según CNBC, es que Singapur le impidió volver al país en febrero de 2026 por haber dado información inexacta sobre su papel en Megaspeed.
Quién dirige ahora Nvidia
Mientras se busca un sustituto, la empresa queda en manos de Colette Kress, hasta ahora directora financiera, que pasa a ser consejera delegada interina sin dejar su puesto anterior, según el 8-K. Un consejero delegado interino es la persona que dirige la compañía de forma temporal, como un capitán provisional que lleva el barco mientras se elige al definitivo. El consejo busca un sucesor permanente entre candidatos internos y externos.
El caso también ha tenido eco político. Según CNBC, la senadora Elizabeth Warren afirmó que Huang sigue debiendo explicaciones al Congreso. Por su parte, el presidente Donald Trump propuso a Tim Cook como sucesor, según PBS; se trata de una opinión que no tiene efecto en la decisión, que corresponde al consejo de Nvidia.
Las crisis que Nvidia ya había superado
En los repasos a su trayectoria se repite que Huang salvó a Nvidia de la quiebra al menos seis veces. Esa cifra no está respaldada: el propio Huang ha contado que la empresa estuvo cerca de la quiebra cuatro o cinco veces, según VnExpress. El episodio mejor documentado es el de 1995, cuando Sega convirtió un contrato con Nvidia en una inversión de 5 millones de dólares, según The Next Web. Y ese rescate no fue obra de una sola persona: el directivo de Sega Shoichiro Irimajiri respaldó la operación ante el consejo de su compañía.
¿Y a mí en qué me afecta?
Aunque parezca una noticia lejana, Nvidia fabrica buena parte de los chips con los que funcionan los servicios de inteligencia artificial que usamos a diario, así que su estabilidad interesa a mucha gente. Además, el caso pone el foco en los controles de exportación de chips, una política que influye en qué empresas y países pueden acceder a la tecnología más avanzada.
Algunas ideas prácticas para seguir esta historia con criterio:
- Distingue lo confirmado de lo publicado. La dimisión, la fecha y el nombre de la consejera delegada interina son hechos oficiales; la sospecha de espionaje y las relaciones posteriores a la primera son informaciones periodísticas sin confirmar.
- No tomes decisiones de inversión por un titular. Si tienes fondos que incluyen grandes tecnológicas, consulta su composición y la información oficial antes de mover tu dinero.
- Acude a la fuente original. En empresas cotizadas en Estados Unidos, los comunicados ante la SEC, como el 8-K, son la referencia más fiable de lo que la compañía reconoce.
- Si diriges un negocio, revisa tus normas internas. El caso recuerda la importancia de tener reglas claras sobre conflictos de interés y relaciones entre responsables y personas a su cargo.
En resumen
Jensen Huang, cofundador de Nvidia en 1993, dimitió el 12 de noviembre de 2026 como presidente, consejero delegado y miembro del consejo, y Colette Kress dirige la empresa de forma interina mientras se busca un sucesor. Huang reconoció una relación con Alice Huang, dirigente de la empresa singapurense Megaspeed, investigada por sus vínculos con China; las sospechas de que ella sea agente de inteligencia no están probadas y China lo niega. Otras relaciones publicadas después siguen sin confirmar, Nvidia no ha dado ningún motivo oficial para la dimisión y la idea de que Huang salvó a la empresa de seis quiebras no se sostiene: él mismo habla de cuatro o cinco ocasiones.
Fuentes
- SEC: formulario 8-K de Nvidia sobre la transición del consejero delegado
- SEC: informe anual 10-K de Nvidia (ejercicio 2007)
- ABC News: Nvidia CEO Jensen Huang resigns amid alleged affair with reported spy
- Axios: Jensen Huang resigns as Nvidia CEO
- Axios: Nvidia CEO Jensen Huang admits affair, board to launch investigation
- PBS NewsHour: What we know after Jensen Huang's resignation
- NBC News: Nvidia opens investigation after CEO Jensen Huang's affair
- TechCrunch: The unfolding Jensen Huang scandal, a timeline
- CBS News: Megaspeed's vacant offices raise questions about ties to Nvidia and China
- CNBC: Why Singapore keeps turning up in the fight over Nvidia chips and China
- CNBC: actualizaciones en directo sobre la salida de Jensen Huang
- Gizmodo: China Is Racing to Exploit an Nvidia Loophole
- TipRanks / The Fly: Megaspeed investigated by U.S. officials over ties to China
- Variety: Nvidia CEO Jensen Huang Resigns After Multiple Affairs
- Yahoo Finance: Nvidia live updates following Jensen Huang's resignation
- The Next Web: Jensen Huang thanks Sega for the $5m that saved Nvidia in 1995
- VnExpress International: From near-bankruptcy to $5T AI empire
- Wikipedia: Jensen Huang spying scandal
- Wikipedia: Jensen Huang
Caída de Microsoft 365: qué pasó con Outlook y Teams y qué se sabe
Fecha: 2026-11-13 15:42:40Autor: Alex Rubio
La caída de Microsoft 365 que empezó el jueves 12 de noviembre de 2026 dejó sin correo a empresas, administraciones y particulares de muchos países a la vez. Outlook dejó de cargar los mensajes, Teams dio problemas y otros servicios, como el asistente Copilot, también se vieron afectados en un fallo que se prolongó durante más de un día.
Detrás hay una historia que ayuda a entender cómo funciona la nube y cómo puede fallar: servidores que se desconectan solos, una carga de trabajo que pasa de unos a otros como fichas de dominó y una causa que, en el momento de escribir este artículo, Microsoft todavía no ha explicado del todo. Te contamos qué se sabe, qué se ha exagerado y qué puedes sacar en claro si tu trabajo depende de estas herramientas.
Qué ocurrió en la caída de Microsoft 365
Todo empezó en Exchange Online, según explica eldiario.es. Exchange Online es el servicio que guarda el correo, el calendario y los contactos de millones de cuentas en los servidores de Microsoft. Es como un buzón alojado en un edificio ajeno: tu Outlook, en el ordenador o en el móvil, no guarda el correo por sí mismo, sino que va a recogerlo a ese buzón cada vez que lo abres. Si el edificio tiene problemas, da igual que tu ordenador funcione perfectamente.
Según CNBC, los problemas de conexión comenzaron poco antes de la una de la tarde, hora del este de Estados Unidos, es decir, hacia las siete de la tarde en la España peninsular. Primero falló Outlook en sus versiones web, de escritorio y móvil, y después Microsoft identificó posibles efectos en Teams, SharePoint Online, Microsoft 365 Copilot y herramientas de seguridad y gestión para empresas como Defender XDR, Intune y Purview.
Sobre otros servicios hay que ser prudentes. Se ha dicho que también cayeron Power BI, la conexión ActiveSync que usan muchos móviles o Microsoft Graph, la «ventanilla» por la que los programas piden datos al ecosistema de Microsoft. Sin embargo, en las fuentes revisadas para este artículo no aparece confirmación de ninguno de esos tres casos, así que conviene tomarlos como no verificados.
¿Cuántas personas se vieron afectadas?
Se suele decir que la caída afectó a «millones de personas», pero no existe un recuento oficial. El medio chipriota Politis recoge que más de 140.000 usuarios de 74 países informaron de problemas con Outlook a través de Downdetector, una web donde la gente comunica fallos de servicios. Hay que tener en cuenta que esa cifra mide quejas, no afectados reales: muchas personas sufren el problema y no lo notifican en ninguna parte.
También ha circulado la cifra de más de 130.000 avisos solo de Outlook en Estados Unidos, pero no aparece en ninguna fuente fiable consultada. Y el dato de más de 430 millones de usuarios que la propia Microsoft atribuye a sus aplicaciones de 365 es el total de clientes, no el número de personas que se quedaron sin servicio.
Por qué se cayó: servidores que se apagan solos
Para entender el fallo hay que conocer una pieza clave de cualquier gran servicio en internet: las comprobaciones de estado, conocidas en inglés como health checks. Son revisiones automáticas que preguntan a cada servidor, cada poco tiempo, si está respondiendo bien. Si no contesta como se espera, el sistema lo retira para que no reciba peticiones de los usuarios. Funciona como un portero que no deja pasar a quien no responde correctamente, algo útil hasta que el problema está en el propio portero.
Eso es, en esencia, lo que pasó. Microsoft informó de que algunos servidores quedaron fuera de servicio tras fallar esas comprobaciones automáticas, según recoge Infobae. Al retirarlos, el trabajo que hacían pasó al resto de servidores, que se encontraron con más peticiones de las que podían atender y empezaron a fallar también. La compañía lo describió como una gran cantidad de servidores que dejaron de estar disponibles de forma inesperada, lo que desplazó la carga al resto de la infraestructura, según la cita recogida por la cadena australiana ABC.
Es lo que los ingenieros llaman un fallo en cascada. Piensa en un supermercado con diez cajas: si cierran tres de golpe, las colas se trasladan a las otras siete; si estas se desbordan y van cerrando, el último cajero acaba con toda la tienda delante.
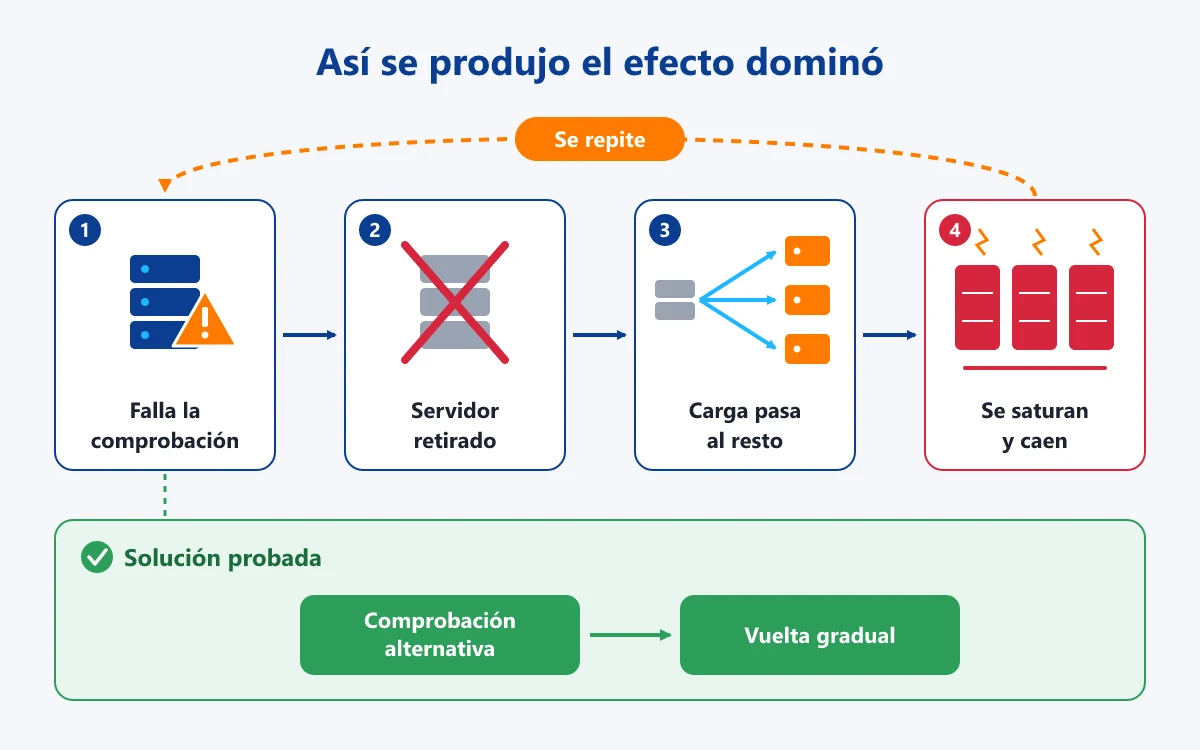
Un arreglo que tardó en funcionar
Microsoft respondió reiniciando servidores, redistribuyendo el tráfico (es decir, desviando las peticiones de los usuarios hacia máquinas sanas) y aplicando ajustes de configuración. Algún análisis independiente añade que la empresa congeló los cambios en sus sistemas mientras investigaba, una práctica habitual, aunque ese detalle solo aparece en un blog técnico y no en comunicados recogidos por la prensa.
La recuperación no fue sencilla. Microsoft anunció una vuelta gradual al servicio, pero poco después reconoció que los servidores restaurados volvían a dejar de responder, según ABC News. Al devolverles tráfico, se veían otra vez desbordados. Por eso la compañía cambió de enfoque y probó un método alternativo de comprobación de estado en una parte de los servidores afectados, para evitar que siguieran retirándose solos.
¿Cuál fue la causa? Lo que todavía no se sabe
Aquí es donde más cuidado hay que tener. Algunos análisis que reconstruyen los avisos de Microsoft apuntan a que se saturó el proceso que establece las conexiones seguras en los servidores, la parte que cifra la comunicación entre tu ordenador y el buzón. Es una explicación plausible, pero no es una causa oficial: Microsoft no ha publicado todavía una causa raíz definitiva.
También ha circulado que Microsoft deshizo un cambio reciente en su red que coincidía con el inicio del fallo. La información disponible es contradictoria. Según el seguimiento oficial recogido por la prensa, la empresa llegó a decir que no había identificado ningún cambio reciente relacionado con el inicio del problema, aunque más tarde señaló que podía tener que ver con un cambio en un componente que procesa esas comprobaciones de estado. Por tanto, la idea de una vuelta atrás en la red que lo explique todo no está confirmada.
Lo que sí está claro es que no hay indicios de un ciberataque. Charles Lamanna, vicepresidente ejecutivo de Microsoft, afirmó que nada apunta a actividad maliciosa, según han recogido medios como Politis y CBC News. En Australia, el responsable de Ciberseguridad del Gobierno trasladó que Microsoft no sospecha de un ataque. Conviene precisar que esto es lo que la empresa le comunicó, no una conclusión propia del Gobierno australiano tras una investigación. Un ciberataque es una acción externa y deliberada; una caída como esta puede deberse a un error interno sin que haya ningún culpable de fuera.
A quién afectó y cuánto duró
El impacto fue amplio y muy variado:
- Empresas: Workhorse Group, fabricante de vehículos eléctricos con sede en Detroit, aplazó la conferencia de sus resultados trimestrales por las interrupciones causadas por la caída.
- Instituciones de Estados Unidos: el correo de agencias federales y del Capitolio se vio afectado, y la oficina que gestiona la informática de la Cámara de Representantes confirmó problemas en sus despachos, según Politico.
- Gobiernos de otros países: Plataforma Media, con información de Al Jazeera, menciona efectos en los Gobiernos de Singapur y Japón, en el Tribunal Supremo de Filipinas y en la policía federal y la agencia de inteligencia de Australia.
- Aerolíneas: IndiGo, Akasa Air y Air India avisaron de que su atención al cliente por correo electrónico estaba afectada.
También se ha dicho que en Australia cerraron oficinas de atención al público, pero ese dato no aparece en las fuentes consultadas.
En cuanto a la duración, las cifras que hablaban de unas siete horas de caída se quedaron cortas muy pronto. Diversas fuentes recogen ya más de 15 y más de 17 horas de interrupción, y Microsoft seguía devolviendo servidores al servicio poco a poco, sin una fecha confirmada para la recuperación total.
Eso sí, no todo se detuvo. Se ha repetido la idea de que una sola falla lo paró todo, y es una exageración: según un aviso de estado de Microsoft, se cayeron las funciones de 365 que dependían de Exchange Online y del correo, mientras que las que no dependían de él siguieron funcionando. Además, las organizaciones que tienen los programas de Microsoft instalados en sus propios servidores, en lugar de en la nube, se libraron en buena parte.
¿Y a mí en qué me afecta?
Si usas Outlook o Teams en el trabajo, lo más probable es que tus mensajes no se hayan perdido. Microsoft amplió a 48 horas el tiempo que los correos pueden esperar en cola antes de darse por fallidos, precisamente para proteger los mensajes retrasados durante la recuperación. Algunos consejos sencillos para este tipo de situaciones:
- No reenvíes una y otra vez el mismo correo: es probable que llegue cuando el servicio se normalice.
- Consulta la página de estado oficial del servicio o a tu departamento informático antes de tocar la configuración de tu equipo. Si el fallo es del proveedor, cambiar ajustes no lo arregla.
- Ten un canal alternativo para lo urgente: un teléfono, una cuenta de correo de otro proveedor o un grupo de mensajería con tus clientes y compañeros.
- Desconfía de mensajes que pidan tu contraseña con la excusa de la caída: los momentos de confusión son aprovechados a menudo para intentar engaños.
Para un negocio, la pregunta de fondo es cuánto depende de un único proveedor. Algunos analistas del sector consideran que, si la fiabilidad empieza a percibirse como un problema recurrente, las empresas tendrán motivos para pensarse dos veces si concentrar más servicios en un solo proveedor. No se trata de abandonar la nube, que sigue ofreciendo ventajas evidentes, sino de saber qué pasaría si mañana el correo no funciona y tener preparado un plan B.
En resumen
La caída de Microsoft 365 nació en Exchange Online, el servicio que aloja el correo de Outlook, y se extendió por un efecto dominó: servidores retirados por comprobaciones automáticas que pasaban su trabajo a otros hasta desbordarlos. Afectó a empresas, gobiernos y aerolíneas de decenas de países y se prolongó más de un día. Microsoft descarta un ciberataque, pero aún no ha publicado la causa definitiva, así que algunas explicaciones que circulan, como la de un cambio de red revertido, no están confirmadas. La lección práctica es sencilla: conviene saber de qué servicios depende tu trabajo y tener una alternativa preparada para cuando fallen.
Fuentes
- eldiario.es: Caída global de Microsoft: qué ha pasado, por qué y cuándo podrían volver a funcionar Outlook y Teams
- CNBC: Microsoft outage continues, Outlook and other 365 services down
- Infobae: Microsoft reconoció que aún no logra resolver los problemas de la caída global
- Politis: Microsoft Rules Out Cyberattack as Global Outage Continues
- CBC News: Microsoft's global outage extends into 2nd day
- SecurityWeek: Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams
- NBC News: Microsoft services hit by major outage across the world
- CNN: Microsoft outage live updates
- Politico (vía Yahoo News): Congressional offices paralyzed by Microsoft outage
- Star-Advertiser: Microsoft outage disrupts businesses, governments worldwide
- Plataforma Media: Microsoft outage hits 74 countries
- Science Media Centre: expert reaction to Microsoft outage
- Yahoo Noticias: Microsoft enfrenta caída global de sus servicios
- Windows Forum: Exchange Online Outage EX1550543
- vonng.com: Ten Hours Without Exchange
Spyware en iPhone a través de anuncios y webs legítimas: qué se sabe
Fecha: 2026-11-12 22:30:34Autor: Alex Rubio
Las empresas de ciberseguridad iVerify y Report URI han documentado campañas de spyware en iPhone que se distribuyen a través de anuncios online y de webs legítimas que sus responsables no saben que están comprometidas. El spyware es un programa espía: se instala en el teléfono sin permiso y extrae información de él. Según la investigación, en algunos casos basta con que un iPhone sin actualizar cargue una página o un anuncio para que el ataque se ponga en marcha, sin que la persona pulse nada.
El informe conjunto se publicó el 22 de octubre de 2026, de acuerdo con Forbes, y desde entonces ha tenido nueva cobertura en medios como AppleInsider y Axios. Su interés va más allá del caso concreto: según iVerify, herramientas de espionaje que antes se usaban contra políticos, periodistas y otros perfiles destacados están pasando a manos de delincuentes comunes que buscan contraseñas y criptomonedas. La buena noticia es que Apple ya corrigió los fallos aprovechados, así que la defensa principal está al alcance de cualquiera: tener el iPhone al día.
Cómo funciona la campaña de spyware en iPhone con dominios caducados
Muchas webs no cargan todo su contenido desde su propio servidor. Para mostrar un chat de atención al cliente, un contador de visitas o un anuncio, insertan pequeños fragmentos de código de terceros, conocidos como etiquetas o scripts, que se descargan desde el dominio de otra empresa. Funciona como una tienda que alquila un expositor a un proveedor externo: la tienda pone el espacio y el proveedor decide qué se muestra en él.
El problema aparece cuando ese proveedor desaparece. Si su dominio caduca, es decir, deja de pagarse y renovarse, cualquiera puede volver a registrarlo, igual que un número de teléfono antiguo que pasa a otra persona. Según Report URI, los atacantes compraron dominios caducados que seguían enlazados desde webs en funcionamiento y colocaron en ellos su propio código. A partir de ese momento, cada visita a esas páginas legítimas cargaba el código de los atacantes, que podía redirigir a los visitantes con un iPhone vulnerable hacia el spyware.
Report URI ha bautizado esta operación como DeadTag. Las cifras varían según la fuente. La más citada habla de al menos 6.600 webs legítimas con unos 49 millones de visitas al mes, aunque otra cobertura eleva la cifra a casi 8.000 webs. En cuanto a los dominios comprados, unas fuentes mencionan unos 630 y otras unos 680. Los investigadores añaden un matiz importante: solo 248 de esas webs actuaban como puntos de entrega directa del código malicioso, con una audiencia combinada de unos 8 millones de visitantes mensuales. Además, según la investigación, los responsables crean hasta diez dominios nuevos cada semana.
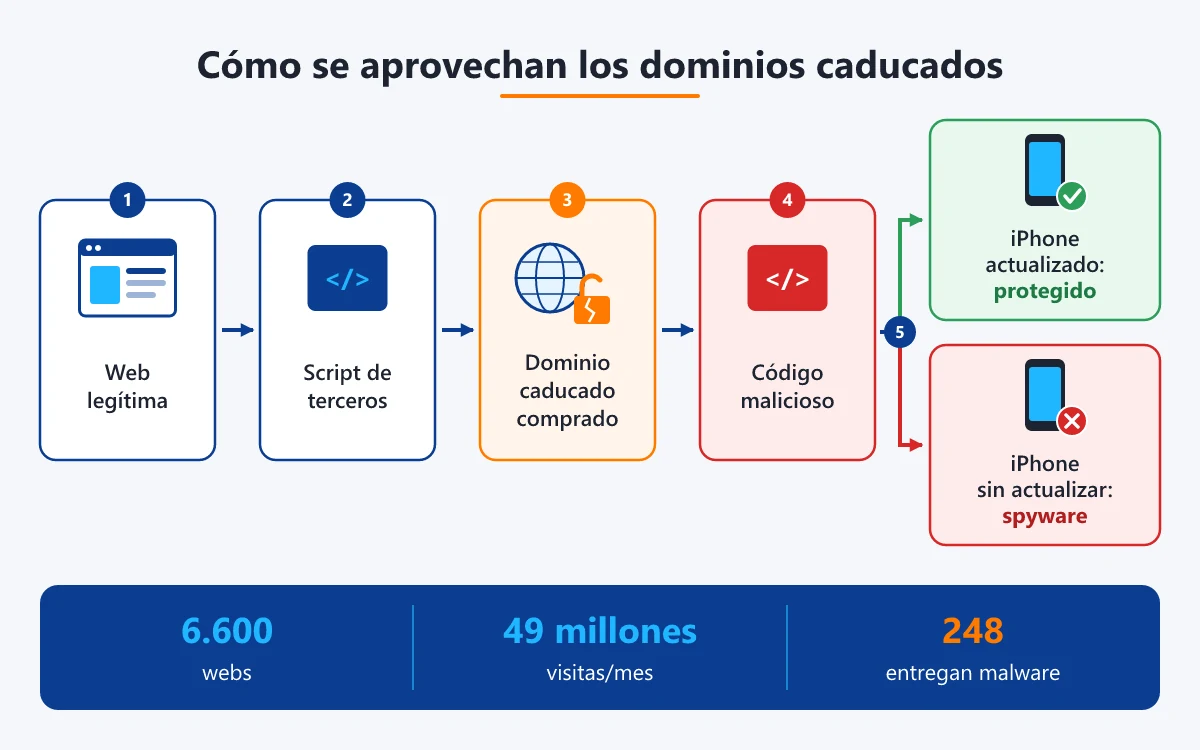
Anuncios maliciosos y kits de explotación filtrados
La segunda vía es la publicidad maliciosa, conocida en inglés como malvertising: anuncios aparentemente normales que llevan escondido código dañino. Según iVerify, el iPhone de un empleado de una entidad financiera se infectó al pasar por delante de un anuncio de un partido de fútbol en Instagram. De acuerdo con AppleInsider, ese ataque robó las credenciales de inicio de sesión de la persona y buscó en sus carteras de criptomonedas.
Para entrar en el teléfono, los atacantes usaron kits de explotación. Un exploit es un programa que aprovecha un fallo del software para tomar el control de un dispositivo, como quien usa el defecto de una cerradura a modo de llave maestra. Un kit reúne varios exploits listos para usar, de modo que no hace falta ser experto para lanzar el ataque. Los kits identificados se llaman Coruna y DarkSword.
Según SecurityWeek, Coruna utiliza cinco cadenas completas de exploits y 23 vulnerabilidades en dispositivos con iOS 13 a iOS 17.2.1. DarkSword, por su parte, apuntaba a iPhones con iOS 18.4 a iOS 18.7 y explotaba seis vulnerabilidades. En los dos casos, los afectados son usuarios que no han actualizado su sistema. Cabe un último dato del mismo caso: según iVerify, aquel empleado sufrió un segundo intento con otra variante de DarkSword, y esta vez sí hizo falta pulsar un enlace.
Del espionaje selectivo al delito común
Durante años, los ataques más sofisticados contra iPhone se asociaban a operaciones contra objetivos muy concretos. Según iVerify, este año los delincuentes comunes estuvieron detrás del 75% del spyware de iPhone que la empresa detectó, gracias a kits filtrados y ocultos en anuncios. Conviene leer esa cifra con cuidado: refleja lo observado entre los usuarios de iVerify, no en el conjunto de iPhones del mundo, y no hemos encontrado una medición independiente que la confirme.
Tampoco está claro quién está detrás. Algunas coberturas apuntan a posibles vínculos con China, pero ni iVerify ni Report URI han identificado públicamente a los atacantes, de modo que esa atribución debe considerarse sin confirmar. A esto se suma que no es un caso aislado: según la empresa Sekoia, citada por Infobae, una campaña distinta atribuida a Rusia infectó en noviembre de 2026 iPhone y Android desactualizados con solo abrir un sitio web.
Lo que se dice del spyware en iPhone y lo que dicen los datos
| Afirmación que circula | Veredicto | Qué dicen los datos |
|---|---|---|
| Cualquier iPhone se infecta solo con mostrar un anuncio | Exagerado | Hay un caso documentado por iVerify con un anuncio en Instagram, pero el ataque solo funciona en versiones concretas y sin actualizar, como iOS 18.4 a 18.7 en el caso de DarkSword. |
| No hace falta tocar nada | Incompleto | Fue así en el caso del anuncio, pero una segunda variante de DarkSword contra la misma persona necesitó que pulsara un enlace. |
| Ya no se ataca solo a políticos y periodistas, sino a gente corriente | Cierto, con matiz | Es lo que señala iVerify con su cifra del 75%, aunque procede de sus propios usuarios y no hay una medición independiente. |
| Más de 6.600 webs legítimas con 49 millones de visitas al mes | Cierto, con matiz | Es la cifra más citada, pero solo 248 webs entregaban el código directamente, con unos 8 millones de visitantes mensuales. |
| Los dueños de las webs no lo sabían | Cierto | Los investigadores indican que las webs cargaban el código sin conocimiento de sus responsables. |
| Los atacantes compraron dominios caducados | Cierto | Confirmado por Report URI, aunque el número de dominios varía según la fuente: unos 630 o unos 680. |
| Podían robar contraseñas, mensajes y criptomonedas | Parcialmente sin confirmar | Se confirma el robo de credenciales y la búsqueda en carteras de criptomonedas; no hemos encontrado fuentes que mencionen el robo de mensajes. |
| Apple ya ha corregido los fallos | Cierto | Apple publicó parches en marzo de 2026, también para versiones antiguas, y Google confirmó que las seis vulnerabilidades de DarkSword están corregidas en iOS 26.3. |
| El informe es de esta misma semana | Desactualizado | La investigación base se publicó el 22 de octubre de 2026; la cobertura posterior se apoya en ella. |
Por último, no existe una cifra total de víctimas. Los investigadores advierten de que sus datos reflejan lo detectado entre sus clientes, por lo que cualquier número sobre cuántas personas han sufrido el ataque en todo el mundo carece hoy de respaldo.
Qué significa para ti
Si tu iPhone está actualizado, estos ataques concretos no deberían funcionar, porque los fallos que aprovechan ya están corregidos. El riesgo real lo corren los teléfonos que se quedan atrás en las actualizaciones, ya sea por descuido o porque el modelo es antiguo. Por eso conviene revisar varios ajustes:
- Actualiza ahora: entra en Ajustes, General y Actualización de software, e instala lo que esté pendiente.
- Activa las actualizaciones automáticas: en ese mismo menú, según Apple, la opción Respuestas de seguridad y archivos del sistema permite instalar correcciones de seguridad en segundo plano.
- Si tu iPhone no admite la última versión: Apple ha publicado parches para versiones anteriores; puedes instalar la última versión corregida de iOS 18 o pasar a iOS 26 si tu modelo lo permite.
- Valora el Modo Aislamiento: iVerify lo recomienda si no puedes actualizar o si tu trabajo te convierte en objetivo. Está en Ajustes, Privacidad y seguridad, y limita funciones para reducir las vías de ataque.
Si gestionas una web, el caso también te afecta. Revisa qué scripts de terceros carga tu página y elimina los de servicios que ya no usas, porque un dominio caducado enlazado desde tu web puede acabar en manos de un desconocido.
En resumen
iVerify y Report URI han documentado campañas que distribuyen spyware en iPhone a través de anuncios y de miles de webs legítimas que cargaban código desde dominios caducados comprados por los atacantes. El riesgo es real, pero se limita a versiones de iOS sin actualizar, y algunas ideas que circulan, como que basta cualquier anuncio para infectar cualquier iPhone o que se roban mensajes, son exageradas o no están confirmadas. Apple ya ha corregido los fallos, de modo que mantener el teléfono actualizado sigue siendo la protección más eficaz.
Fuentes
- iVerify: investigación sobre malvertising, Coruna y DarkSword
- Forbes: Hackers Are Serving Malware To iPhones Via Hundreds Of Infected Websites
- Axios (vía Yahoo Tech): Hackers are turning web browsing into a spyware trap
- AppleInsider: Malicious ads can infect vulnerable iPhones without a single tap
- Apple Support: Apple security releases
- Apple Support: About the security content of iOS 26.3 and iPadOS 26.3
- The Hacker News: Apple Expands iOS 18.7.7 Update to More Devices to Block DarkSword Exploit
- SecurityWeek: Apple Updates Legacy iOS Versions to Patch Coruna Exploits
- Infobae: Una campaña atribuida a Rusia infectó iPhone y Android desactualizados con solo abrir un sitio web
Qué es un ataque CSRF y cómo puede cambiar tu contraseña
Fecha: 2026-11-10 20:06:54Autor: Alex Rubio
Imagina que haces clic en un enlace que parece inofensivo y, sin enterarte de nada, acabas de cambiar la contraseña de una de tus cuentas. No has rellenado ningún formulario ni has confirmado nada: simplemente has pinchado. Eso, en esencia, es un ataque CSRF, una de las vulnerabilidades web más curiosas porque aprovecha algo que usas todos los días: tu sesión abierta en una web de confianza.
En este artículo te explicamos qué es un ataque CSRF con palabras sencillas, cómo consigue colarse un atacante y, sobre todo, qué medidas reales lo frenan. También aclararemos algunas ideas que circulan sobre este tema y que no son del todo exactas, para que te quedes con la foto correcta.
Qué significa CSRF y por qué importa
CSRF son las siglas de Cross-Site Request Forgery, que se traduce como «falsificación de peticiones entre sitios», según recoge la Wikipedia. El nombre es técnico, pero la idea es fácil: un sitio malicioso logra que tu navegador envíe una orden a otra web distinta, en la que tú tienes la sesión iniciada, para que se ejecute una acción que tú no has querido hacer.
La clave está en cómo funcionan las sesiones. Cuando entras en una web y escribes tu usuario y contraseña, el sitio no te pide las credenciales en cada clic. En su lugar, guarda en tu navegador un pequeño identificador llamado cookie. Es como la pulsera de un festival: una vez te la ponen en la entrada, pasas por cualquier zona sin tener que mostrar la entrada otra vez. El problema es que tu navegador envía esa «pulsera» de forma automática con cada petición que hace a esa web, venga de donde venga el clic.
Según la documentación sobre CSRF de GeeksforGeeks, el ataque se basa precisamente en eso: el navegador adjunta la cookie de sesión sin preguntar, así que si un atacante consigue que tu navegador envíe una orden, esa orden llegará con tu identidad puesta. Interesa a cualquiera, no solo a los informáticos, porque la víctima no tiene que introducir datos ni cometer ningún error evidente: basta un clic.
Cómo se cuela el atacante paso a paso
Veamos el ejemplo más citado: un formulario para cambiar la contraseña. En un diseño vulnerable, ese formulario solo pide la nueva contraseña (dos veces para confirmar) y no vuelve a pedir la contraseña actual. Al pulsar «guardar», tu navegador envía la nueva contraseña junto con tu cookie de sesión, y la web da por buena la orden.
Aquí conviene hacer una aclaración. A veces se presenta este formulario «flojo» como el caso habitual, pero no lo es: es un ejemplo de mal diseño. La guía de pruebas de seguridad de OWASP recomienda pedir de nuevo la contraseña actual al cambiarla, precisamente para proteger una sesión que alguien haya podido dejar abierta. Es decir, el fallo existe cuando el desarrollador no toma esa precaución, no porque sea lo normal.
El segundo ingrediente es el tipo de petición. En la web existen dos formas básicas de comunicarse: las peticiones GET, pensadas para pedir y leer datos (como cuando escribes una dirección en el navegador), y las POST, pensadas para enviar datos, como al mandar un formulario. Las acciones que modifican algo deberían usar POST. Si una web permite, por error, cambiar la contraseña mediante una simple GET, entonces los datos del cambio se pueden meter directamente en una dirección web. Y una dirección web es muy fácil de compartir: basta con un enlace.
OWASP advierte en su guía de prevención de CSRF de que usar GET para acciones que cambian datos es un riesgo, y recomienda reservar GET solo para leer. Que esto no es teórico lo demuestra un caso documentado por el investigador Sjoerd Langkemper, que describió un cambio de contraseña mediante CSRF en un programa de recursos humanos. Así que la afirmación de que «enviando los datos por GET la contraseña cambia sin confirmación» es cierta, pero con un matiz importante: solo ocurre si la aplicación acepta ese cambio por GET.
Del experimento al ataque real
Una vez el atacante tiene un enlace que ejecuta la acción, necesita que la víctima haga clic. Para ello recurre a la ingeniería social, que no es más que el arte de engañar a una persona para que haga algo. El enlace se puede disfrazar con un acortador de direcciones o esconder detrás de un texto con apariencia legítima dentro de un correo, como describe la guía sobre CSRF de Graylog. Cuando la víctima pincha, su propio navegador envía la petición con su cookie de sesión, y la acción se ejecuta con su identidad.
Sobre este punto circula una idea que conviene matizar. Se dice a veces que, como el atacante «ya conoce el nombre de usuario», le basta con iniciar sesión luego con la nueva contraseña. En la práctica no es tan automático: el CSRF no revela quién es la víctima, el atacante necesita saber de antemano a qué cuenta dirige el ataque y no todos los sitios permiten entrar solo con el nombre de usuario. No hemos encontrado una fuente que describa ese paso como una regla general, así que es mejor tomarlo como un escenario posible, no como algo que ocurra siempre.
Que el riesgo es real lo confirma la historia. Según la Wikipedia, las vulnerabilidades CSRF se conocen y, en algunos casos, se han explotado desde 2001. La misma fuente recuerda que en 2008 una plataforma de vídeos muy popular tuvo un fallo CSRF que permitía realizar casi cualquier acción en nombre de cualquier usuario. No es un problema de laboratorio.
Las defensas que de verdad funcionan
La buena noticia es que el CSRF tiene remedios conocidos. Se suelen citar tres medidas, y conviene explicarlas bien porque a veces se presentan como una solución que lo corta «de raíz», algo que es exagerado. OWASP insiste en la idea de defensa en profundidad: combinar varias barreras, porque ninguna por sí sola es infalible.
Token CSRF único por formulario
Un token CSRF es un valor secreto y aleatorio que la web incluye en cada uno de sus formularios y que solo su propia página conoce. Cuando llega una petición, el servidor comprueba que trae ese valor. Un sitio ajeno no puede adivinarlo, así que no puede falsificar la orden. OWASP lo sitúa como la defensa principal frente al CSRF.
Cookies con el atributo SameSite
El atributo SameSite es una instrucción que le dice al navegador cuándo debe enviar una cookie si la petición viene desde otro sitio. Desde 2020, tanto Mozilla como Google aplican el valor Lax por defecto, como explica Mozilla Hacks. Esto ayuda, pero tiene un límite importante: con Lax, el navegador sigue enviando la cookie cuando sigues un enlace mediante una petición GET, según la documentación de MDN. Por eso OWASP advierte de que, si una acción que cambia datos es accesible por GET, SameSite no la detendrá. Es decir, SameSite es un refuerzo, no un escudo completo.
Pedir siempre la contraseña actual
Para la acción concreta de cambiar la contraseña, pedir de nuevo la contraseña actual es una barrera sencilla y eficaz, tal como recomienda OWASP. Un atacante que solo ha conseguido que hagas clic en un enlace no conoce tu contraseña actual, así que la petición falsificada no supera esa comprobación.
A todo esto se suma un recordatorio: existe otro tipo de fallo llamado XSS (cross-site scripting), en el que el atacante logra insertar código en la propia web legítima. Si ese fallo existe, puede saltarse las defensas CSRF. Por eso no basta con una sola medida.
¿Y a mí en qué me afecta?
Como usuario normal no programas webs, pero sí puedes reducir el riesgo con hábitos sencillos:
- Desconfía de los enlaces que llegan por correo o mensajería, sobre todo si están acortados o te empujan a pinchar con urgencia. Pasar el ratón por encima para ver la dirección real ayuda.
- Cierra sesión en los servicios sensibles (banca, correo, administración) cuando termines, en lugar de dejarlos siempre abiertos.
- Usa navegadores actualizados, que ya aplican SameSite por defecto y te protegen en parte sin que hagas nada.
- Activa la verificación en dos pasos donde sea posible: añade una barrera extra aunque una contraseña quede comprometida.
Y si tienes o gestionas una web, las recomendaciones del dossier son claras: usa POST (no GET) para cualquier acción que modifique datos, incorpora tokens CSRF en los formularios, configura las cookies con SameSite y pide la contraseña actual al cambiarla.
En resumen
Un ataque CSRF aprovecha que tu navegador envía automáticamente tu sesión para ejecutar, con tu identidad, una acción que tú no has pedido, muchas veces con un simple clic en un enlace disfrazado. Es un riesgo real y antiguo, pero con defensas bien conocidas: tokens únicos por formulario, cookies con SameSite y pedir la contraseña actual en los cambios sensibles. Ninguna de esas medidas lo resuelve por sí sola, pero combinadas convierten un ataque cómodo en uno muy difícil. Para ti, la mejor protección sigue siendo pensar dos veces antes de hacer clic.
Flipper One: qué es y para qué sirve el ordenador Linux de bolsillo
Fecha: 2026-11-10 19:39:17Autor: Alex Rubio
El Flipper One es el nuevo aparato de Flipper Devices, la empresa que se dio a conocer con el Flipper Zero, ese pequeño dispositivo con aspecto de juguete capaz de leer tarjetas, mandos a distancia y otras señales. A pesar del parecido en el nombre, el Flipper One es otra cosa: un ordenador de bolsillo con Linux pensado para trabajar con redes, que la compañía presentó oficialmente en mayo de 2026.
Desde entonces circulan muchas ideas sobre lo que puede hacer: router de viaje, herramienta para revisar redes, ordenador para programar o equipo de inteligencia artificial sin conexión. Algunas son ciertas, otras dependen de piezas que se compran aparte y otras todavía no se han podido comprobar, porque el equipo aún no está a la venta. Aquí repasamos qué es, qué lleva dentro y qué se sabe con seguridad.
Qué es el Flipper One y qué no es
Se suele decir que el Flipper One es un Flipper Zero más potente, pero en realidad no es así. La propia Flipper Devices afirma en su página oficial que no se trata de una actualización del Zero. Los dos aparatos trabajan en niveles distintos de la tecnología, y entender esa diferencia es la clave de todo lo demás.
Una forma sencilla de verlo es imaginar las comunicaciones como un edificio de varias plantas. En la planta baja están las señales sueltas entre aparatos: el NFC con el que pagas con el móvil, las tarjetas de acceso de una oficina (RFID), la radio de los mandos de garaje (sub-GHz) o el infrarrojo del mando de la tele. Ahí vive el Flipper Zero. El Flipper One, en cambio, trabaja en las plantas de arriba, las de las redes IP, que es el idioma con el que se entienden ordenadores, routers e internet.
De hecho, según la especificación oficial, el Flipper One no incluye NFC, RFID, radio sub-GHz ni infrarrojos como funciones básicas. Por eso no sirve para copiar una tarjeta o abrir una puerta de garaje. Si se resume diciendo que el Zero conversa con aparatos y el One con redes enteras, la comparación encaja bien con lo que describen las fuentes.
Tampoco es exacto describirlo como un móvil. Flipper Devices lo presenta como una plataforma Linux portátil de hardware abierto, una multiherramienta de redes y de «IA en el borde», que significa inteligencia artificial que funciona en el propio aparato en lugar de en servidores lejanos. Medios como Cyberpress lo llaman cyberdeck, un término informal para los ordenadores portátiles orientados a la experimentación y la seguridad.
Qué lleva dentro
Según CNX Software y la información oficial, el corazón del Flipper One es un procesador Rockchip RK3576 con ocho núcleos (cuatro Cortex-A72, más potentes, y cuatro Cortex-A53, más ahorradores), una gráfica Mali-G52 y un NPU de 6 TOPS. El NPU es un chip especializado en tareas de inteligencia artificial, y los TOPS indican cuántos billones de operaciones por segundo puede hacer en teoría; es una cifra máxima, no una medida de rendimiento real.
Lo acompañan 8 GB de memoria RAM, 64 GB de almacenamiento interno y una ranura para tarjetas microSD. Además, incluye un pequeño microcontrolador, el RP2350, que actúa como un conserje: se encarga de la pantalla, los botones, el panel táctil y la gestión de la batería, para que el procesador principal no tenga que ocuparse de esas tareas.
En conexiones es donde se nota su vocación. Tiene dos puertos Ethernet gigabit (las tomas de cable de red, más estables que el Wi-Fi), Wi-Fi 6E en las bandas de 2,4, 5 y 6 GHz, Bluetooth, un puerto USB-C que puede hacerse pasar por un adaptador de red y una salida HDMI 2.1 capaz de dar imagen 4K a 120 Hz. Por dentro esconde una ranura M.2, un conector del tamaño de un chicle como el que llevan muchos portátiles para el disco, donde se pueden instalar módulos de ampliación.
El sistema es Linux, basado en Debian, con herramientas propias de la marca llamadas Flipper OS y FlipCTL. No es Android ni Kali Linux, y no hay confirmación oficial de que Kali funcione en él. La empresa colabora con la compañía Collabora para que el soporte del procesador llegue al núcleo principal de Linux y, según XDA Developers y Chiptron, ha abierto el desarrollo a la comunidad y pide ayuda para terminar el proyecto.
Para qué sirve el Flipper One: los usos que se le atribuyen
Con esas piezas sobre la mesa, se pueden revisar uno a uno los usos que más se repiten. Conviene tener presente que el equipo sigue en desarrollo, así que algunas promesas todavía no se han podido probar en el aparato definitivo.
Revisar redes
Los dos puertos Ethernet están confirmados. Se ha dicho que basta con colocarlo entre el router y un ordenador para ver todo lo que pasa por el cable, pero las fuentes consultadas no describen ese montaje y el comportamiento del hardware final al enrutar tráfico está pendiente de verificar. Analizar redes es una práctica habitual de los auditores de seguridad, siempre con autorización del dueño de la red, pero eso es una costumbre del sector, no una función concreta del producto.
Router de bolsillo con VPN
Una VPN es como un túnel privado: cifra lo que envías y lo hace salir por un servidor de confianza, algo útil en el Wi-Fi público de un hotel. El diseño del Flipper One apunta a este tipo de usos, porque combina Linux, Ethernet, Wi-Fi y funciones de enrutamiento. Sin embargo, no se ha encontrado una prueba de este escenario concreto en el equipo final, así que por ahora es una posibilidad, no una función comprobada.
Internet móvil en cualquier parte
Es cierto que la ranura M.2 admite módems 4G y 5G. La documentación oficial la describe como una entrada para módems, tarjetas Wi-Fi, radios SDR, discos NVMe, módulos de posicionamiento y aceleradores de IA. El matiz importante es que el módem no viene incluido en la configuración base: hay que comprarlo aparte.
Un ordenador de escritorio con Linux
Este uso sí está confirmado. Gracias a la salida HDMI, se puede conectar a un monitor o una tele, añadir teclado y ratón y usarlo como un ordenador Linux para programar o trabajar. Eso sí, el sistema todavía se está puliendo.
Inteligencia artificial sin internet
El chip existe, pero la función aún no está lista. Según las fuentes, el soporte del NPU en Linux y las capacidades finales de IA siguen en desarrollo, igual que el entrenamiento del modelo. La idea es ejecutar programas de IA en el propio aparato, sin enviar datos fuera, pero todavía no se puede afirmar qué tal funcionará.
Un equipo modular
Por último, la ranura M.2 permite añadirle un disco NVMe, una radio SDR (una radio controlada por software que sirve para captar y analizar señales) o un acelerador de IA. Son usos previstos por el fabricante, aunque todos dependen de módulos opcionales que se compran por separado.
Precio y disponibilidad
Aquí también conviene precisar. El 3 de noviembre de 2026 se abrieron las reservas mediante un cupón digital de 20 dólares que, según Pasquale Pillitteri, GIGAZINE y Xakep, da derecho a comprar una unidad por 379 dólares cuando empiece la campaña de Kickstarter. Ese precio es el del cupón, no el precio de venta final, y los 20 dólares del cupón se pagan aparte.
Según el fabricante, el cupón es reembolsable y no equivale a comprar el aparato. En mayo, la empresa se había marcado como objetivo un precio inferior a 350 dólares para la versión base sin módulo celular, una cifra que finalmente ha subido. La campaña de Kickstarter estaba prevista para noviembre de 2026, sin fecha garantizada, y en el momento de escribir este artículo aún no había comenzado.
¿Y a mí en qué me afecta?
Para la mayoría de la gente, el Flipper One es todavía un proyecto interesante más que un producto que se pueda comprar. Si te llama la atención, estos consejos pueden ayudarte a decidir:
- Elige según lo que quieras hacer. Si te interesan las tarjetas, los mandos y las señales de radio cotidianas, el Flipper One no está pensado para eso. Si te interesan las redes y Linux, encaja mejor.
- Cuenta con los extras. El módem 4G/5G, el disco o la radio SDR se compran aparte, y el precio final aún no es definitivo.
- No compres por funciones futuras. La IA local y algunos usos de red siguen en desarrollo; es prudente esperar a pruebas con el equipo final.
- Recuerda que el cupón no es una compra. Solo reserva el derecho a adquirirlo a un precio concreto.
- Úsalo de forma legal. Analizar el tráfico de una red solo es aceptable si es tuya o si tienes permiso expreso de su dueño.
En resumen
El Flipper One es un ordenador de bolsillo con Linux, hardware abierto y orientación a redes, no una versión mejorada del Flipper Zero. Su hardware está confirmado: procesador RK3576, dos puertos Ethernet gigabit, Wi-Fi 6E, salida HDMI, ranura M.2 y un chip de IA de 6 TOPS. En cambio, usos como el router de viaje con VPN, el análisis de tráfico en línea o la IA sin conexión todavía no se han comprobado en el equipo definitivo. Y los 379 dólares son un precio de reserva ligado a un cupón, no el precio de venta, con una campaña de financiación que aún no ha arrancado.
Fuentes
- Flipper Devices: página oficial del Flipper One
- Flipper Devices: página de reserva del Flipper One
- Documentación oficial del Flipper One
- CNX Software: Flipper One, a Rockchip RK3576-powered portable Arm Linux computer and networking multi-tool
- Hackster.io: Flipper Devices Unveils the Flipper One, a Powerful Pocket-Sized Computer
- XDA Developers: The Flipper One is finally official, but Flipper isn't selling it yet
- Pasquale Pillitteri: Flipper One Launches Pre-Orders, $379 With a $20 Coupon
- GIGAZINE: Pre-orders have begun for Flipper One
- Xakep: apertura de reservas del Flipper One (en ruso)
- Habr: Flipper One, listo para su lanzamiento en Kickstarter (en ruso)
- Chiptron.eu: Flipper One officially unveiled and seeking development help
- Cyberpress: Flipper Devices Unveils Flipper One Modular Linux Cyberdeck
- Linuxadictos: Flipper One, the new Linux cyberdeck
- Yahoo Tech: Flipper unveils a Linux-powered networking gadget built for hackers and tinkerers
- ITechGuides: Flipper One might finally be coming: release date, specs, price
- GitHub: awesome-flipper-one (repositorio comunitario)
Discord reescribe en Rust sus apps y deja Electron y React Native
Fecha: 2026-11-10 19:06:27Autor: Alex Rubio
Discord reescribirá en Rust sus aplicaciones de escritorio y móvil, y dejará atrás Electron y React Native, las dos tecnologías basadas en código web sobre las que funcionan hoy. Lo confirmó su cofundador y director de tecnología, Stanislav Vishnevskiy, en un mensaje publicado en X el 4 de noviembre, según recogen medios como heise e Inven Global. El paso de Discord a Rust está todavía en fase de demostración y no tiene fecha de lanzamiento.
La noticia interesa más allá del mundo de la programación. Discord es una aplicación de mensajería y voz muy extendida, y su consumo de memoria en el ordenador ha sido una queja habitual entre sus usuarios. Además, el anuncio llega dos meses después de que Shopify comunicara que también abandona React Native, aunque con una estrategia muy distinta.
Qué cambia con Discord en Rust
Para entender el cambio conviene saber cómo está construido Discord ahora. En el ordenador usa Electron, una herramienta que permite crear programas de escritorio con las mismas tecnologías que una página web. Cada aplicación hecha con Electron incluye su propio motor de navegador, Chromium, y su propio motor de JavaScript. Es como si cada programa llevara dentro un navegador completo, y eso tiene un coste en memoria.
En el móvil, Discord utiliza React Native, un sistema que permite escribir una única aplicación en JavaScript y publicarla tanto en iOS como en Android. Su gran ventaja es que el equipo no tiene que programar dos veces lo mismo. Sin embargo, añade una capa intermedia entre el código y el teléfono que puede afectar a la velocidad.
Rust, el lenguaje elegido para el relevo, está pensado para ofrecer seguridad y rendimiento sin necesitar un navegador ni un intérprete que consuma memoria mientras el programa funciona. No es una novedad para la empresa: según Inven Global, Vishnevskiy explicó que Discord usa Rust desde 2018 y que buena parte de su infraestructura y de su tecnología de voz ya funciona con él. Lo nuevo es llevarlo a las aplicaciones que instala el usuario.
Cómo será la nueva arquitectura
El proyecto, que internamente se llama Discord Phoenix según ShiftDelete.net, tiene dos piezas. La idea central es un núcleo compartido: la lógica común de la aplicación se escribe una sola vez en Rust y la aprovechan todas las plataformas. Funciona como una receta maestra que varios restaurantes adaptan después a su propio local.
En el ordenador: una interfaz dibujada con la tarjeta gráfica
En escritorio, la interfaz se dibujará con GPUI, un sistema creado por Zed Industries para su editor de código Zed. Según heise, GPUI no depende de tecnologías web, sino de su propio sistema de interfaz acelerado por la tarjeta gráfica, de forma parecida a como se dibuja un videojuego. Por eso Discord no ha optado por Tauri, otra alternativa basada en Rust que, según ShiftDelete.net, sigue mostrando una página web dentro de la vista del navegador del sistema.
Hay dos matices. El primero es que GPUI todavía no ha llegado a la versión 1.0 y, según heise, los cambios entre versiones suelen romper la compatibilidad, lo que supone un riesgo de mantenimiento. El segundo es que no todo dejará de ser web: según bool.dev, los contenidos incrustados, como los vídeos de plataformas externas y las Actividades, seguirán usando la vista web del sistema operativo.
En el móvil: lógica en Rust e interfaz nativa
En iOS y Android, las pantallas se harán con las herramientas propias de cada sistema, lo que se conoce como interfaz nativa: Swift en el iPhone y Kotlin en Android. La lógica compartida con el escritorio irá en Rust, según las fuentes consultadas. Discord no ha publicado documentación detallada de esta arquitectura.
El modelo tiene precedentes. 1Password, el gestor de contraseñas, usa un núcleo en Rust para el cifrado y la sincronización, con interfaces propias en cada plataforma, según Rustify. Signal, la aplicación de mensajería, también concentra la mayor parte de su lógica en un núcleo Rust compartido por todas sus versiones, según Daily.dev.
Mientras tanto, la aplicación actual sigue recibiendo mejoras. Según MobileNApps, en septiembre de 2026 Discord actualizó sus apps móviles de React Native 0.81 a 0.86, lo que, según la empresa, redujo ligeramente el uso del procesador y acortó un 5 % el tiempo de arranque.
Shopify, el caso que va en dirección contraria
El 10 de septiembre de 2026, Shopify anunció que pasaba todas sus aplicaciones móviles a Swift y Kotlin y abandonaba React Native, según DEV Community e InfoQ. Su argumento fue la inteligencia artificial: los asistentes de programación pueden trasladar una función de una plataforma a otra, y eso reduce la principal ventaja de escribir el código una sola vez.
A esto se suman las cifras que la propia empresa ha difundido, recogidas por Daily.dev: reconstruir la app Shop con su sistema interno Helix llevó 12 semanas, y el resultado arranca más rápido en Android, ocupa 109 MB menos y sufre diez veces menos cierres inesperados que la versión con React Native. Son datos de Shopify que no han sido verificados de forma independiente.
La diferencia de fondo con Discord es clara. Shopify deja de compartir código entre iOS y Android, mientras que Discord sigue compartiéndolo, pero en Rust en lugar de JavaScript.
Lo que se dice del paso de Discord a Rust y lo que dicen los datos
Alrededor del anuncio circulan varias ideas. Esta tabla repasa las más repetidas y su grado de exactitud según las fuentes disponibles.
| Afirmación | Veredicto | Explicación |
|---|---|---|
| Discord abandona Electron y React Native para pasarse a Rust. | Cierto | Vishnevskiy escribió que ambas tecnologías desaparecen, según heise. |
| La app actual es una web dentro de un navegador y supera 1 GB de memoria sin hacer nada. | Exagerado | Electron sí incluye un motor de navegador. Pero, según DEV Community, un empleado de Discord afirmó en diciembre de 2025 que el uso normal está por debajo de 1 GB, y la empresa probó a reiniciar la app de forma automática al llegar a 4 GB. No hemos localizado la declaración original. |
| Todo, incluidos los servidores, se escribirá de cero en Rust. | Incompleto | Lo que se reescribe es la aplicación del usuario. Los servidores no forman parte de ese cambio, y Rust ya se usa en la infraestructura de Discord desde 2018, según Inven Global. |
| La nueva versión para Windows usa solo 290 MB de memoria con dos cuentas abiertas. | Cierto, pero insuficiente como prueba | Una captura del Administrador de tareas mostró 290,2 MB en una versión de desarrollo, y el CTO dijo que tenía dos cuentas abiertas, según bool.dev. Es una única configuración, sin comparación controlada con la app actual. |
| En un Android barato, la nueva app abre en menos de un segundo. | Cierto en una demo; sin confirmar en uso real | Discord mostró el cliente nuevo junto al actual en teléfonos Android antiguos y de gama baja, según pbxscience y Tech Insider. La empresa no ha dicho qué modelo usó. |
| JavaScript desaparece por completo de la app móvil. | Sin confirmar | No hemos encontrado documentación oficial que lo confirme. |
| El nuevo cliente es una demo sin fecha de lanzamiento. | Cierto | No hay fecha confirmada. Según Daily.dev, Discord espera llevarlo pronto a pruebas con usuarios a través de sus versiones de prueba. |
| Shopify se fue porque escribir la app dos veces ya no importa. | Incompleto | Shopify reconoce que el coste sigue existiendo: según la empresa, citada por DEV Community, tener software nativo significa construir y mantener dos plataformas, y ese coste no ha desaparecido. |
| Todas las grandes empresas que usaban React Native lo han abandonado en dos meses. | Falso | Solo hay dos casos confirmados, y siguen caminos distintos. Según Rocky Soft, Coinbase busca personal para una reescritura similar, pero eso no equivale a un abandono confirmado. |
Qué significa para ti
Si usas Discord, de momento no cambia nada: la aplicación que tienes instalada seguirá siendo la misma hasta que la nueva versión llegue a las pruebas públicas. Si las cifras de las demostraciones se mantienen en uso real, el beneficio más visible sería un menor consumo de memoria en el ordenador y arranques más rápidos en móviles modestos, pero eso todavía está por demostrar.
Si diriges una empresa o un equipo de desarrollo, el caso de Discord y el de Shopify muestran que no existe una única respuesta correcta. Ambas compañías parten de necesidades distintas y han llegado a conclusiones opuestas sobre compartir código. Algunas recomendaciones prácticas:
- No cambies de tecnología solo porque lo haga una gran empresa: valora el tamaño de tu equipo, tu presupuesto y lo que realmente falla en tu aplicación.
- Mide antes de decidir. Una captura puntual de memoria no equivale a una medición continua en distintos equipos.
- Ten en cuenta la madurez de las herramientas. Un sistema sin versión estable, como GPUI, puede obligar a rehacer trabajo con cada actualización.
- Si mantienes apps para varias plataformas, estudia el modelo de núcleo compartido con interfaz nativa que ya usan 1Password y Signal.
En resumen
Discord ha confirmado que reescribirá en Rust sus aplicaciones de escritorio y móvil, con una interfaz de escritorio basada en GPUI y apps móviles con pantallas nativas y lógica compartida. Las primeras demostraciones muestran 290 MB de memoria en Windows y arranques rápidos en móviles de gama baja, pero son pruebas aisladas, sin comparativas publicadas ni fecha de lanzamiento. Shopify también ha dejado React Native, aunque para dejar de compartir código, y no hay pruebas de un abandono generalizado de esa tecnología por parte de las grandes empresas.
Fuentes
- heise: Discord is rebuilding in Rust, leaving React and Electron behind
- Inven Global: Discord CTO confirms the desktop and mobile apps are being rebuilt in Rust
- bool.dev: Discord Rebuilds Its Apps in Rust and Drops Electron
- ShiftDelete.net: Discord Rust Rewrite
- MobileNApps: Discord Confirms Rust Rebuild
- DEV Community: Discord Swapped Electron for Rust. The 290MB Claim Needs a Caveat
- pbxscience: Discord shows off Rust-built Android app
- Tech Insider: Discord Android Rust App
- Daily.dev: Discord's Rust rewrite
- InfoQ: Shopify Drops React Native for Swift and Kotlin
- DEV Community: Shopify Left React Native: 4 Questions Before You Follow
- Daily.dev: Shopify is moving away from React Native
- Rocky Soft: Shopify leaving React Native, should your app go native?
- Rustify: 1Password
- Daily.dev: How Signal and WhatsApp secure billions of devices with Rust
- Wikipedia: Discord